
Comment indexer un site web complet pour un chatbot IA
Planifiez, explorez et vérifiez un site web complet sans importer d'espaces compte, de pages de recherche, de bruit de navigation ni d'URL dupliquées.
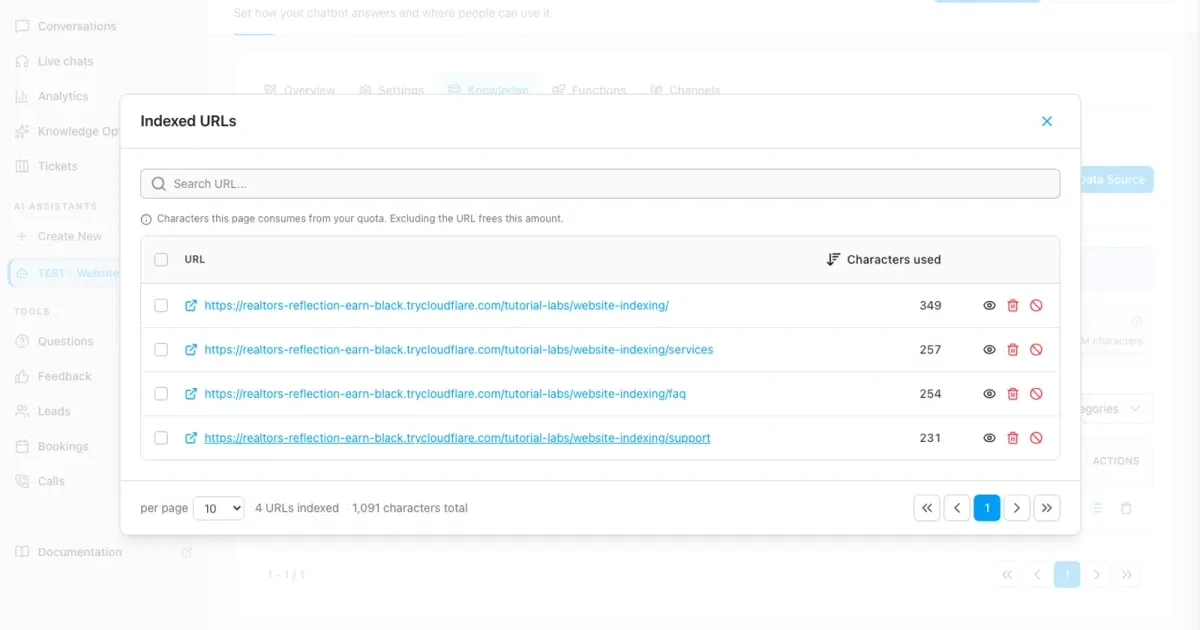
Pour indexer un site web complet de manière fiable pour un chatbot, définissez d'abord l'inventaire exact des pages utiles et vérifiez à la fois le contenu extrait et les réponses après l'exploration.
Un site web complet correspond rarement à l'ensemble des URL qu'un robot d'exploration peut découvrir. Les résultats de recherche, les écrans de compte, les parcours de panier, les versions imprimables, les archives d'étiquettes et les doublons traduits peuvent consommer votre quota tout en rendant les réponses moins fiables. L'objectif sûr est d'obtenir un ensemble complet de pages publiques utiles.
Ce guide s'appuie sur un site de support fictif Northstar doté d'un inventaire de pages réduit et documenté. Vous commencerez par une exploration limitée, inspecterez chaque URL indexée ainsi que son texte extrait, éliminerez le bruit récurrent grâce à des règles d'exclusion, puis validerez la récupération avec des questions prédéfinies avant d'activer la réindexation automatique.
La démonstration vérifiée explore exactement quatre pages canoniques, écarte les variantes privées, de recherche et d'impression, récupère `two business hours` ainsi que `NORTHSTAR-SITE-42`, refuse d'inventer des frais 2029 absents et enregistre un intervalle de réindexation de sept jours. Le compte temporaire est ensuite supprimé sans laisser d'utilisateurs tutoriels résiduels.
Lecteur vidéo respectueux de la vie privée (en deux clics)
Votre chatbot a exploré les MAUVAISES pages : corrigez l'indexation du site
Indexez votre site pour un chatbot IA : gestion de l'exploration, sélecteurs CSS, exclusions, audits d'URL et réindexation automatique.
Le lecteur YouTube reste bloqué jusqu'à ce que vous cliquiez sur Lecture. Son chargement connecte votre navigateur à YouTube et peut transmettre des données techniques à Google.
Ouvrir directement sur YouTubeCe que vous maîtriserez à la fin
- Un inventaire écrit des familles d'URL incluses, exclues et dupliquées
- Une source de site web contrôlée avec une profondeur d'exploration testée, l'extraction `main` et des exclusions
- Un audit page par page des URL indexées, des caractères et du contenu extrait
- Un jeu de tests de régression répétable portant sur des réponses connues et des informations manquantes
- Un intervalle d'actualisation adapté au responsable du contenu plutôt qu'un calendrier arbitraire
Avant de commencer
- L'autorisation d'explorer l'hôte et le chemin d'accès publics exacts
- Un plan de site (sitemap) ou un inventaire manuel des modèles de pages importants
- Les structures connues de comptes, de commandes, de recherches, d'impressions, de paramètres et de langues dupliquées
- Un responsable du contenu ainsi qu'au moins deux questions associées à des réponses vérifiées par les sources
- Un quota suffisant de caractères indexables restants pour la première exploration contrôlée
Découvrir largement, indexer de façon sélective
La profondeur d'exploration contrôle le nombre de niveaux de liens découverts à partir de l'URL de départ. La valeur zéro limite l'exécution à la page saisie ; la valeur un atteint les pages directement liées ; un champ vide supprime la limite fixe de profondeur. Les règles d'exclusion empêchent les pages correspondantes d'entrer dans l'index, tandis que leurs liens peuvent toujours aider à la découverte.
Les sélecteurs CSS répondent à une question différente : quelle partie de chaque page acceptée devient une connaissance. Un sélecteur tel que `main` peut supprimer le texte récurrent de navigation et de pied de page, mais il doit exister sur tous les modèles de pages. Le statut Completed prouve que le traitement est terminé. Les URL indexées et les tests de réponses prédéfinis prouvent que les bonnes pages et les faits corrects sont réellement utilisables.
01–09
Configuration pas à pas
Cartographier le site web avant de lancer l'exploration
Séparez les pages utiles des chemins réservés à la découverte, privés et dupliqués.
Exportez le plan de site ou listez manuellement les URL représentatives. Regroupez-les en contenu obligatoire, contenu facultatif, variantes dupliquées et pages interdites. Notez la langue canonique et déterminez si les paramètres modifient le contenu ou uniquement le tri, le suivi et la présentation.
Le laboratoire fictif Northstar prévoit quatre pages utiles sous `/tutorial-labs/website-indexing/` : vue d'ensemble, services, support et FAQ. Les variantes privées, de recherche et d'impression sont exclues. L'inventaire sert d'oracle de test : toute page inattendue invalide l'exécution, même si le statut de la source est vert.
- Pages utiles attendues : 4
- Familles exclues : privées, recherche et impression
- Langue canonique : anglais
Ouvrir Website sous le bon assistant
Vérifiez l'assistant, le forfait, le quota et l'avertissement de propriété avant d'ajouter une URL.
Ouvrez l'assistant isolé `Website Crawl Lab`, choisissez Data Sources, sélectionnez Add Data Source puis Website. La boîte de dialogue indique explicitement de n'ajouter que les sites web dont vous êtes propriétaire. Arrêtez-vous si l'hôte, le chemin ou l'autorisation ne correspondent pas au périmètre approuvé.
Consultez la carte Training data usage avant l'exploration. Enregistrez le total de caractères actuel afin de pouvoir imputer la progression à cette source. Un modèle plus puissant ne compense pas une exploration trop large ou non autorisée.
Définir le chemin de départ et une première profondeur limitée
Commencez avec un périmètre suffisamment restreint pour pouvoir examiner chaque page découverte.
Saisissez la racine stable du laboratoire Northstar et utilisez la profondeur 2 pour la première exécution contrôlée. La profondeur 0 n'indexerait que la vue d'ensemble. La profondeur 1 atteint les liens directs. Une profondeur vide supprime la limite fixe de niveau et ne doit être utilisée que lors d'une exécution ultérieure, une fois les exclusions éprouvées.
Restez dans la racine de la section au lieu de démarrer sur la page d'accueil du domaine. WebChatAgent restreint la découverte au chemin de départ, ce qui rend l'usage de sources de sites web distinctes pratique lorsque la documentation, le marketing et le support nécessitent des sélecteurs ou des calendriers d'actualisation différents.
N'utilisez pas la profondeur illimitée comme un raccourci
Validez d'abord le nombre de pages, les exclusions et l'extraction avec une profondeur limitée. Développez d'un niveau à la fois et comparez l'écart.
Conserver le contenu principal et exclure le bruit d'URL récurrent
Utilisez un sélecteur unique présent sur l'ensemble des modèles et des règles explicites sensibles à la casse.
Développez Advanced. Définissez le sélecteur CSS sur `main` uniquement après avoir vérifié les pages de vue d'ensemble, de services, de support et de FAQ. Un sélecteur absent d'un modèle peut générer une page vide, tandis qu'un sélecteur trop large répète les menus, les bandeaux de cookies et les liens de pied de page dans chaque fragment.
Ajoutez des règles d'exclusion exactes pour les variantes privées, de recherche et d'impression du laboratoire. Les règles sont sensibles à la casse. Vérifiez chacune d'elles par rapport à des URL réelles ; un fragment large tel que `/shop` peut exclure involontairement `/workshop`. Les pages exclues restent hors de l'index, mais leurs liens peuvent toujours être suivis pour la découverte.
- Sélecteur CSS : `main`
- Exclusions : chemin privé, chemin de recherche et paramètre d'impression
- N'excluez pas automatiquement les pages légales si le bot doit s'en servir pour répondre
Lancer l'opération une seule fois et interpréter correctement chaque statut
Attendez le statut Completed ; interrompez délibérément l'opération si le périmètre est manifestement incorrect.
Sélectionnez Add & Index une seule fois. Pending signifie en attente, Processing indique que les pages sont en cours de récupération et d'extraction, Failed ou Error nécessite d'identifier la cause exacte, et Stopped signifie qu'un utilisateur a interrompu l'exécution. Ne créez pas de seconde source simplement parce que la première tâche semble lente.
Si le nombre de pages ou le total de caractères dépasse largement l'inventaire, cliquez sur Stop, conservez les éléments de preuve et examinez les règles avant de réessayer avec un compte vierge. Completed confirme que la tâche est terminée ; cela ne garantit pas encore un contenu propre ni des réponses correctes.
Auditer la liste des URL indexées et le quota
Comparez les URL exactes et le nombre de caractères par page avec l'inventaire.
Ouvrez Indexed URLs depuis la ligne du site web. Le laboratoire doit contenir exactement les quatre pages canoniques prévues. Recherchez `private`, `search`, `print`, les points d'interrogation et les variantes de doublons avec barre oblique finale. Notez le nombre total de caractères et comparez l'écart par rapport au niveau de référence initial.
Delete supprime immédiatement une page indexée sélectionnée, mais une exploration ultérieure peut la redécouvrir. Exclude ajoute également une règle durable pour les futures explorations. Utilisez Exclude pour une famille d'URL qui doit rester à l'écart, puis réindexez et vérifiez à nouveau la liste ainsi que le total de caractères.
Inspecter le texte extrait de chaque modèle
Une URL correcte peut tout de même contenir de mauvaises zones de page.
Utilisez View indexed content sur une page de chaque modèle. Vérifiez que le titre, les conditions, les dates et le fait unique restent associés. Recherchez les éléments de navigation répétés, les bandeaux de cookies, le contenu de pied de page non pertinent et les sections manquantes causées par le sélecteur.
La phrase de support connue de Northstar indique que l'objectif de réponse prioritaire est de deux heures ouvrées et comporte la valeur de vérification `NORTHSTAR-SITE-42`. Si cette phrase complète est absente, corrigez l'extraction avant de modifier le modèle ou le prompt.
Valider la récupération et le comportement face aux informations manquantes
Exécutez des questions prédéfinies dans une nouvelle conversation une fois l'indexation terminée.
Posez la question : `What is the Northstar priority support response goal and website verification value?` La réponse attendue est `two business hours` ainsi que `NORTHSTAR-SITE-42`, appuyée sur la page de support. Demandez ensuite des frais d'annulation pour 2029 qui ne figurent pas dans les données de test. La réponse sécurisée doit indiquer que l'information n'est pas disponible et n'inventer aucun montant.
Répétez la question connue avec deux variantes formulées naturellement. Si toutes les variantes ignorent le même fait, vérifiez le contenu extrait et la récupération avant de comparer différents modèles. Conservez ces questions exactes comme jeu de régression pour les explorations ultérieures.
Choisir un intervalle d'actualisation et documenter la référence
Actualisez aussi souvent que le responsable du contenu modifie la source, puis comparez des éléments équivalents.
Modifiez la source du site web uniquement après avoir obtenu un premier résultat propre. Choisissez l'absence de réindexation automatique, une réindexation quotidienne, tous les trois jours, tous les sept jours ou tous les trente jours en fonction de la disponibilité de votre forfait et du rythme de révision du responsable. Une fréquence quotidienne n'est pas nécessairement meilleure pour des pages de politiques statiques.
Après chaque modification de sélecteur, d'exclusion, de fournisseur ou de source, attendez le statut Completed et réexécutez les mêmes questions sur les informations connues et manquantes. Consignez la date, la profondeur, le nombre de pages, les caractères indexés et les résultats. Analysez toute hausse inattendue avant qu'elle n'atteigne la limite de votre forfait.
Exemple et résultat
Découvrez le test pratique et son résultat
Chaque tutoriel présente une saisie précise, le résultat attendu et le récapitulatif transparent des vérifications effectuées localement.
Exemple pratique : comment indexer correctement un site web complet
Ce cas d'usage exact a été exécuté sur un compte de démonstration temporaire.
Données de test exactes
Open the indexed Support page and inspect the extracted `main` content for the response goal and verification value.
Résultat attendu
Le texte de la page enregistrée contient “two business hours” et `NORTHSTAR-SITE-42`, sans éléments de navigation ni contenu de page privée.
Ce qui a été réellement vérifié
L'exploration contrôlée réelle a ouvert la page Support indexée et affiché les deux valeurs dans son contenu extrait, exactement comme l'illustre la capture de preuve.
Conseils et astuces
Rendre la configuration fiable et pérenne
Testez toujours avec des cas réalistes, documentez votre état de référence et n'appliquez qu'un changement à la fois. C'est la seule façon de mesurer de réels progrès.
Séparer les sources par responsabilité et par modèle
La documentation, le marketing et le support nécessitent souvent des sélecteurs, des exclusions, des responsables et des intervalles d'actualisation distincts. Des racines séparées facilitent l'isolation des erreurs et de la consommation de quota.
Traiter les paramètres d'URL comme une décision réfléchie
Ne conservez un paramètre que s'il apporte des connaissances uniques. Les variantes de suivi, de tri, de recherche et d'impression créent généralement des doublons ; testez des exemples précis avant de définir une règle trop large.
Ne supprimez pas les politiques par automatisme
Les pages de confidentialité, de livraison, de garantie ou d'annulation peuvent être essentielles pour répondre aux clients. Excluez une page parce qu'elle est hors sujet ou dupliquée, et non simplement parce qu'il s'agit d'un contenu juridique.
Que faire en cas de problème ?
Dépannage
Vérifiez méthodiquement l'état du service, les autorisations d'accès et les données de test avant de modifier le modèle ou le prompt.
Seule la page de départ apparaît
Vérifiez que la profondeur est supérieure à zéro, que les liens utiles se trouvent bien sous le chemin de départ et que les pages sont reliées par des URL standards. Examinez les URL en échec avant d'augmenter la profondeur.
Une page est indexée mais son texte utile est manquant
Ouvrez View indexed content et testez le sélecteur CSS sur ce modèle précis. Utilisez un sélecteur partagé `main` ou une source spécifique au modèle au lieu de combiner des sélecteurs à l'aveugle.
Les pages exclues réapparaissent après la réindexation
Delete n'affecte que l'index actuel. Ajoutez une exclusion persistante précise, réindexez et vérifiez la liste des URL. Contrôlez la casse et la syntaxe des règles de paramètres.
La consommation de caractères augmente bien plus vite que le nombre de pages
Inspectez les pages les plus volumineuses pour repérer la navigation répétée, le texte de cookies, les listes imbriquées et les variantes de paramètres. Resserrez le sélecteur ou séparez la source avant d'augmenter le quota.
Une source avec le statut Completed donne toujours une mauvaise réponse
Vérifiez le passage exact dans View indexed content, supprimez les doublons contradictoires et relancez la question prédéfinie dans une nouvelle conversation. Ne comparez les modèles qu'une fois la récupération parfaitement fiable.
Prêt pour un test en conditions réelles ?
Conservez l'inventaire des quatre URL et les questions prédéfinies sur les informations connues/inconnues comme référence de validation. Après chaque modification de sélecteur, d'exclusion, de contenu ou de fournisseur, attendez le statut Completed et comparez la nouvelle liste d'URL, le total de caractères, la phrase extraite et les résultats des deux réponses.