
Een volledige website indexeren voor een AI-chatbot
Plan, crawl en verifieer een complete website zonder accountomgevingen, zoekpagina's, navigatieruis of dubbele URL's te importeren.
Om een volledige website betrouwbaar te indexeren voor een chatbot, definieert u eerst de exacte inventaris van nuttige pagina's en controleert u na het crawlen zowel de geëxtraheerde inhoud als de antwoorden.
Een complete website is zelden hetzelfde als elke URL die een crawler kan ontdekken. Zoekresultaten, accountschermen, winkelwagenroutes, printweergaven, tagarchieven en vertaalde duplicaten kunnen quotum verbruiken en antwoorden minder betrouwbaar maken. Het veilige doel is een complete set van nuttige openbare pagina's.
Deze handleiding gebruikt een fictieve Northstar-ondersteuningssite met een kleine, gedocumenteerde paginainventaris. U begint met een beperkte crawl, inspecteert elke geïndexeerde URL en de bijbehorende geëxtraheerde tekst, verwijdert aanhoudende ruis met uitsluitingspatronen en toont vervolgens de accuraatheid aan met vaste vragen voordat u automatische herindexering inschakelt.
Het geverifieerde stappenplan crawlt exact vier canonieke pagina's, houdt privé-, zoek- en printvarianten buiten de deur, haalt `two business hours` plus `NORTHSTAR-SITE-42` op, weigert een ontbrekende 2029-vergoeding te verzinnen en stelt een herindexeringsinterval van zeven dagen in. Het tijdelijke account wordt verwijderd met nul resterende tutorialgebruikers.
Privacyvriendelijke speler met tweestapsactivering
Uw chatbot heeft de VERKEERDE pagina's gecrawld — Herstel website-indexering
Indexeer een website voor een AI-chatbot met gecontroleerde crawldiepte, CSS-selectors, URL-audits, antwoordtests en automatische herindexering.
De YouTube-speler blijft geblokkeerd totdat u op Afspelen klikt. Door het laden maakt uw browser verbinding met YouTube en kunnen technische gegevens naar Google worden verzonden.
Rechtstreeks openen op YouTubeWat u aan het einde heeft bereikt
- Een schriftelijke inventaris van opgenomen, uitgesloten en dubbele URL-families
- Een gecontroleerde websitebron met geteste crawldiepte, `main`-extractie en uitsluitingen
- Een pagina-voor-pagina-audit van geïndexeerde URL's, tekens en geëxtraheerde inhoud
- Een herhaalbare regressieset met bekende antwoorden en ontbrekende informatie
- Een verversingsinterval afgestemd op de contenteigenaar in plaats van een willekeurig schema
Voordat u begint
- Toestemming om de exacte openbare hostnaam en het pad te crawlen
- Een sitemap of handmatige inventaris van belangrijke paginasjablonen
- Bekende patronen voor accounts, checkouts, zoekopdrachten, printversies, parameters en dubbele talen
- Eén contenteigenaar plus twee of meer vragen met bekende, door bronnen onderbouwde antwoorden
- Voldoende resterend quotum voor geïndexeerde tekens voor de gecontroleerde eerste crawl
Ontdek breed, indexeer selectief
De crawldiepte bepaalt hoeveel linkniveaus er worden ontdekt vanaf de start-URL. Nul houdt de run op de ingevoerde pagina; één bereikt direct gelinkte pagina's; een leeg veld verwijdert de vaste dieptelimiet. Uitsluitingspatronen houden overeenkomende pagina's buiten de index, terwijl hun links nog steeds kunnen helpen bij het ontdekken.
CSS-selectors beantwoorden een andere vraag: welk deel van elke geaccepteerde pagina wordt kennis. Een selector zoals `main` kan herhaalde navigatie- en footerteksten verwijderen, maar moet op elk paginasjabloon aanwezig zijn. De status Completed bewijst dat de verwerking is voltooid. Geïndexeerde URL's en vaste antwoordtests tonen aan dat de juiste pagina's en feiten daadwerkelijk bruikbaar zijn.
01–09
Stap voor stap instellen
Breng de website in kaart voordat u de crawler opent
Scheid nuttige pagina's van privé-routes, duplicaten en pagina's die enkel dienen voor ontdekking.
Exporteer de sitemap of maak handmatig een lijst van representatieve URL's. Groepeer ze als vereiste inhoud, optionele inhoud, dubbele varianten en verboden pagina's. Noteer de canonieke taal en controleer of parameters de inhoud wijzigen of alleen sortering, tracking en weergave beïnvloeden.
Het fictieve Northstar-lab verwacht vier nuttige pagina's onder `/tutorial-labs/website-indexing/`: overzicht, diensten, ondersteuning en FAQ. Privé-, zoek- en printvarianten zijn uitgesloten. De inventaris is het testcriterium: onverwachte pagina's laten de run mislukken, zelfs als de bronstatus groen is.
- Verwachte nuttige pagina's: 4
- Uitgesloten families: privé, zoekopdrachten en print
- Canonieke taal: Engels
Open Website onder de juiste assistent
Controleer de assistent, het abonnement, het quotum en de eigendomswaarschuwing voordat u een URL toevoegt.
Open de geïsoleerde `Website Crawl Lab`-assistent, kies Data Sources, selecteer Add Data Source en vervolgens Website. Het dialoogvenster vermeldt uitdrukkelijk dat u alleen websites mag toevoegen waarvan u de eigenaar bent. Stop als de hostnaam, het pad of de toestemming niet overeenkomt met de goedgekeurde scope.
Controleer de kaart Training data usage vóór de crawl. Noteer het huidige totale aantal tekens, zodat groei aan deze bron kan worden toegeschreven. Een sterker model compenseert geen te brede of ongeautoriseerde crawl.
Stel het startpad en een begrensde eerste diepte in
Begin klein genoeg zodat elke ontdekte pagina kan worden beoordeeld.
Voer de stabiele Northstar-lab-root in en gebruik diepte 2 voor de eerste gecontroleerde run. Diepte 0 zou alleen het overzicht indexeren. Diepte 1 bereikt directe links. Een lege diepte verwijdert de vaste niveaulimiet en hoort pas thuis in een latere run nadat uitsluitingen zijn bewezen.
Blijf binnen de sectie-root in plaats van te starten op de homepagina van het domein. WebChatAgent beperkt de ontdekking tot het startpad, wat afzonderlijke websitebronnen nuttig maakt wanneer documentatie, marketing en ondersteuning verschillende selectors of verversingsschema's vereisen.
Gebruik onbeperkt niet als kortere weg
Toon eerst het aantal pagina's, de uitsluitingen en de extractie aan bij een begrensde diepte. Breid met één niveau tegelijk uit en vergelijk het verschil.
Behoud hoofdinhoud en sluit blijvende URL-ruis uit
Gebruik één selector die in alle sjablonen voorkomt en expliciete hoofdlettergevoelige patronen.
Vouw Advanced uit. Stel de CSS-selector pas in op `main` na het controleren van overzicht, diensten, ondersteuning en FAQ. Een selector die ontbreekt op één sjabloon kan een lege pagina opleveren, terwijl een te brede selector menu's, cookieteksten en footerlinks in elk tekstfragment herhaalt.
Voeg exacte uitsluitingspatronen toe voor de privé-, zoek- en printvarianten van het lab. Patronen zijn hoofdlettergevoelig. Controleer elk patroon aan de hand van echte URL's; een te breed fragment zoals `/shop` kan onbedoeld `/workshop` uitsluiten. Uitgesloten pagina's blijven buiten de index, maar hun links kunnen nog steeds worden gevolgd voor ontdekking.
- CSS-selector: `main`
- Uitsluiten: privékanaal, zoekroute en printquery
- Sluit juridische pagina's niet automatisch uit wanneer de bot daaruit antwoorden moet halen
Start één keer en interpreteer elke status correct
Wacht op Completed; stop doelbewust wanneer de scope zichtbaar onjuist is.
Selecteer eenmalig Add & Index. Pending betekent in de wachtrij, Processing betekent dat pagina's nog worden opgehaald en geëxtraheerd, Failed of Error vereist de exacte reden en Stopped betekent dat een persoon de run heeft beëindigd. Maak geen tweede bron aan omdat de eerste taak traag lijkt.
Als het aantal pagina's of het totale aantal tekens ver boven de inventaris uitstijgt, gebruik dan Stop, sla het bewijs op en inspecteer patronen voordat u het opnieuw probeert met een nieuw account. Completed bevestigt dat de taak is beëindigd; het bewijst nog geen schone inhoud of correcte antwoorden.
Controleer de lijst met geïndexeerde URL's en het quotum
Vergelijk exacte URL's en tekens per pagina met de inventaris.
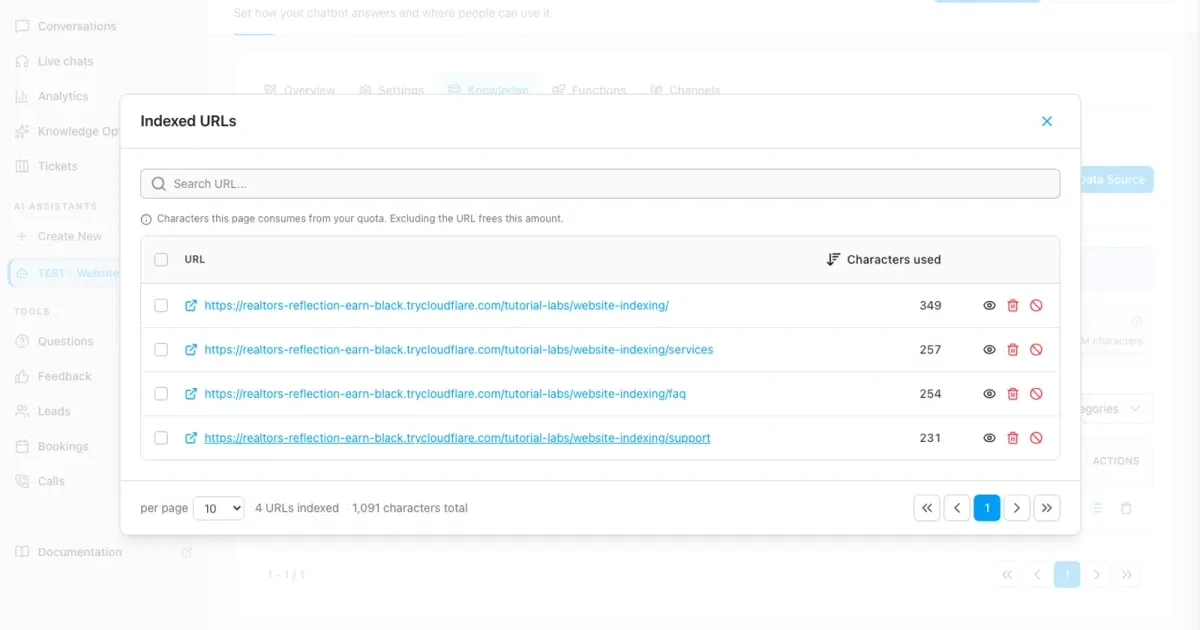
Open Indexed URLs vanuit de websiteregel. Het lab mag exact de vier geplande canonieke pagina's bevatten. Zoek naar `private`, `search`, `print`, vraagtekens en dubbele varianten met een slash aan het einde. Noteer het totale aantal tekens en vergelijk het verschil met de baseline van vóór de crawl.
Delete verwijdert nu een geselecteerde geïndexeerde pagina, maar een latere crawl kan deze opnieuw ontdekken. Exclude voegt ook een blijvend patroon toe voor toekomstige crawls. Gebruik Exclude voor een URL-familie die buiten de index moet blijven, indexeer vervolgens opnieuw en controleer zowel de lijst als het totale aantal tekens opnieuw.
Inspecteer geëxtraheerde tekst van elk sjabloon
Een correcte URL kan nog steeds de verkeerde paginagedeelten bevatten.
Gebruik View indexed content op één pagina van elk sjabloon. Controleer of de kop, voorwaarden, datums en unieke feiten bij elkaar blijven. Zoek naar herhaalde navigatie, cookiebanners, niet-gerelateerde footerinhoud en ontbrekende secties veroorzaakt door de selector.
De bekende ondersteuningszin van Northstar stelt dat de prioritaire reactietijd twee werkuren is en bevat de verificatiewaarde `NORTHSTAR-SITE-42`. Als die volledige zin ontbreekt, herstel dan eerst de extractie voordat u het model of de prompt aanpast.
Bewijs accuraatheid en veilig gedrag bij ontbrekende informatie
Voer vaste vragen uit in een nieuw gesprek nadat het indexeren is voltooid.
Vraag: `What is the Northstar priority support response goal and website verification value?` Het verwachte antwoord is `two business hours` plus `NORTHSTAR-SITE-42`, gebaseerd op de ondersteuningspagina. Vraag vervolgens naar een 2029-annuleringsvergoeding die niet in de gegevens voorkomt. Het veilige antwoord moet aangeven dat de informatie niet beschikbaar is en mag geen bedrag verzinnen.
Herhaal de bekende vraag met twee natuurlijke varianten. Als alle varianten hetzelfde feit missen, keer dan terug naar de geëxtraheerde inhoud en het ophalen van gegevens voordat u modellen vergelijkt. Bewaar deze exacte vragen als regressieset voor latere crawls.
Kies een verversingsinterval en documenteer de baseline
Ververs zo vaak als de contenteigenaar de bron wijzigt en vergelijk vervolgens op gelijke basis.
Bewerk de websitebron pas na het eerste schone resultaat. Kies geen automatische herindexering, dagelijks, elke drie dagen, elke zeven dagen of elke dertig dagen, afhankelijk van de beschikbaarheid binnen uw abonnement en het evaluatieritme van de eigenaar. Dagelijks is niet automatisch beter voor statische beleidspagina's.
Wacht na elke wijziging aan selectors, uitsluitingen, providers of bronnen op Completed en voer dezelfde vragen met bekende en ontbrekende informatie opnieuw uit. Registreer datum, diepte, aantal pagina's, geïndexeerde tekens en resultaten. Onderzoek onverwachte groei voordat deze de limiet van het abonnement bereikt.
Voorbeeld en resultaat
Bekijk de praktijktest en het resultaat
Elke tutorial bevat een vaste invoer, het verwachte resultaat en een transparant overzicht van wat daadwerkelijk lokaal is geverifieerd.
Praktijkvoorbeeld: Hoe u een volledige website correct indexeert
Dit exacte scenario is doorlopen met het tijdelijke tutorial-account.
Exacte testinvoer
Open the indexed Support page and inspect the extracted `main` content for the response goal and verification value.
Verwacht resultaat
De opgeslagen paginatekst bevat “two business hours” en `NORTHSTAR-SITE-42`, zonder navigatie of inhoud van privépagina's.
Wat er daadwerkelijk is geverifieerd
De daadwerkelijke gecontroleerde crawl opende de geïndexeerde pagina Support en toonde beide waarden in de geëxtraheerde inhoud, exact zoals te zien is in het bewijskader.
Tips en trucs
Maak de inrichting betrouwbaar
Test met realistische voorbeelden, leg uw startpunt vast en wijzig één instelling tegelijk. Zo worden echte verbeteringen zichtbaar.
Splits bronnen op basis van eigenaarschap en sjabloon
Documentatie, marketing en ondersteuning vereisen vaak verschillende selectors, uitsluitingen, eigenaren en verversingsintervallen. Afzonderlijke roots maken het gemakkelijker om fouten en quotumgroei te isoleren.
Behandel URL-parameters als een weloverwogen beslissing
Behoud een parameter alleen als deze unieke kennis oplevert. Varianten voor tracking, sortering, zoekopdrachten en printweergaven zorgen meestal voor duplicaten; test exacte voorbeelden voordat u een breed patroon opstelt.
Verwijder beleidspagina's niet uit gewoonte
Pagina's over privacy, verzending, garantie of annulering kunnen essentieel zijn voor antwoorden aan klanten. Sluit een pagina uit omdat deze irrelevant of dubbel is, niet alleen omdat het juridische inhoud betreft.
Wanneer iets niet werkt
Problemen oplossen
Controleer status, machtigingen en testgegevens systematisch voordat u het model of de prompt aanpast.
Alleen de startpagina verschijnt
Controleer of de diepte groter is dan nul, of de nuttige links onder het startpad blijven en of de pagina's met normale URL's zijn gekoppeld. Inspecteer mislukte URL's voordat u de diepte vergroot.
Een pagina is geïndexeerd, maar de nuttige tekst ontbreekt
Open View indexed content en test de CSS-selector op dat specifieke sjabloon. Gebruik een gedeelde `main` of een sjabloonspecifieke bron in plaats van selectors blindelings te combineren.
Uitgesloten pagina's keren terug na herindexering
Delete beïnvloedt alleen de huidige index. Voeg een exacte, blijvende uitsluiting toe, indexeer opnieuw en controleer de URL-lijst. Controleer de syntaxis voor hoofdletters en querypatronen.
Het tekenverbruik groeit veel sneller dan het aantal pagina's
Inspecteer de grootste pagina's op herhaalde navigatie, cookieteksten, ingesloten lijsten en parametervarianten. Maak de selector specifieker of splits de bron voordat u het quotum verhoogt.
Voltooide bron geeft nog steeds een verkeerd antwoord
Verifieer het exacte tekstfragment in View indexed content, verwijder conflicterende duplicaten en voer de vaste vraag opnieuw uit in een nieuwe chat. Vergelijk modellen pas nadat het ophalen van gegevens consistent correct verloopt.
Klaar voor een test op productieniveau
Behoud de inventaris van vier URL's en de vaste bekende/onbekende vragen als release-baseline. Wacht na elke wijziging van selector, uitsluiting, inhoud of provider op Completed en vergelijk de nieuwe URL-lijst, het totale aantal tekens, de geëxtraheerde zin en beide antwoordresultaten.