
Base de connaissances chatbot RAG : préparer les documents
Transformez des pages et des PDF dispersés en un ensemble restreint de sources validées dont les faits importants sont faciles à extraire, vérifier et mettre à jour.
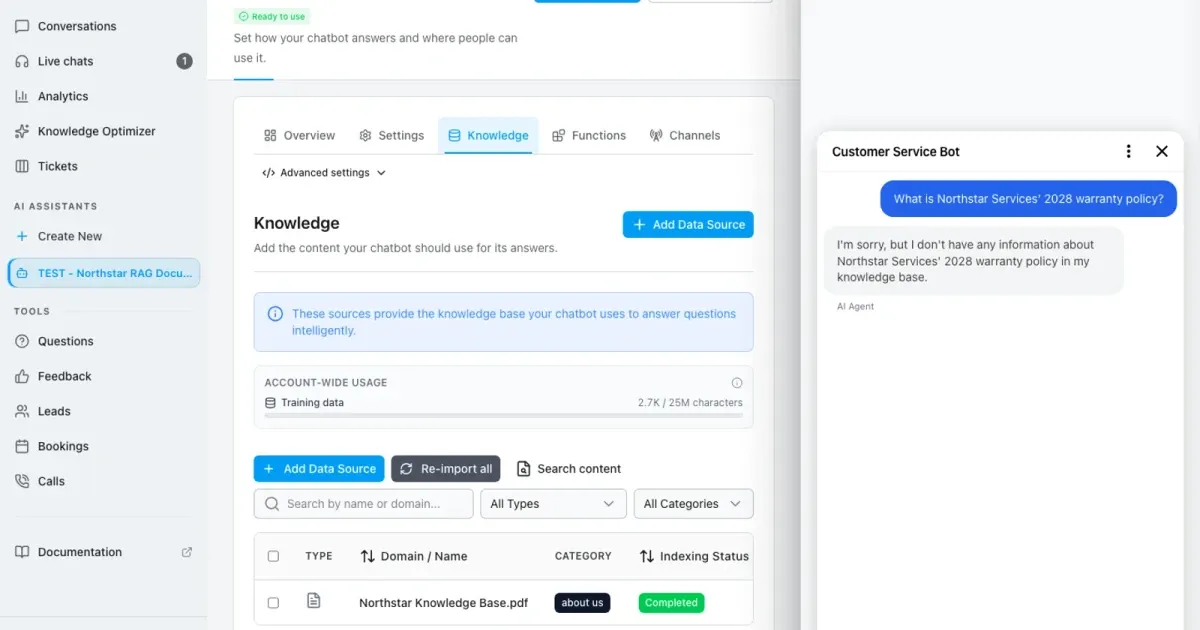
Pour préparer une base de connaissances fiable pour un chatbot RAG, commencez par des documents d'entreprise approuvés et faciles à extraire, dont les passages enregistrés et les limites de réponse sont testés directement.
Un chatbot ne lit pas une base de connaissances comme un collègue qui se souvient de l'intégralité du dossier. Il reçoit généralement quelques passages extraits. Si un extrait indique “this applies for 30 days” alors que le produit, la date d'effet et les exceptions se trouvent ailleurs, la réponse peut être incomplète même si le document original semblait clair pour un humain.
Ce guide commence avant le téléversement. Vous choisirez une source approuvée pour chaque sujet, réécrirez les faits essentiels pour qu'ils soient autonomes, vérifierez l'OCR et l'extraction, puis validerez le résultat indexé avec une question à réponse connue et une question de contrôle délibérément sans réponse. Le PDF de démonstration Northstar fournit le fait unique NORDSTERN-42, afin que le résultat ne puisse pas être confondu avec les connaissances générales du modèle.
Ne téléversez pas tout un disque partagé simplement parce qu'il est accessible. Une collection actuelle plus restreinte, dotée de responsables, de dates de révision et de questions reproductibles, est bien plus fiable qu'une vaste archive contenant des versions contradictoires.
Lecteur vidéo respectueux de la vie privée (en deux clics)
Bonnes pratiques pour base de connaissances RAG : optimisez les sources de votre chatbot
Préparez votre base de connaissances RAG : éliminez les doublons, optimisez l'extraction, inspectez le texte et testez vos réponses.
Le lecteur YouTube reste bloqué jusqu'à ce que vous cliquiez sur Lecture. Son chargement connecte votre navigateur à YouTube et peut transmettre des données techniques à Google.
Ouvrir directement sur YouTubeCe que vous maîtriserez à la fin
- Un registre des sources avec un responsable désigné et une date de révision par sujet
- Des pages et des documents optimisés pour la recherche contenant des faits autonomes
- Des fichiers sources vérifiés par OCR, dédupliqués et clairement versionnés
- Une source WebChatAgent indexée dont le texte enregistré est visiblement vérifié
- Un test de validation reproductible avec réponse connue et information manquante
Avant de commencer
- L'accès aux fichiers sources validés et aux pages publiques, et pas seulement à des copies exportées
- Un responsable de contenu capable de résoudre les contradictions et d'approuver la version actuelle
- Le PDF de démonstration fictif téléchargeable Northstar ou un autre document de test non confidentiel
- Cinq à dix vraies questions d'utilisateurs, dont au moins une à laquelle les sources ne doivent pas répondre
- Un assistant de test WebChatAgent isolé avec l'interface en anglais et le Light Mode activé
La recherche fonctionne par passages : le contexte local est donc primordial
Le terme technique est Génération Augmentée par Récupération (RAG) : le système recherche d'abord les passages pertinents dans l'ensemble de sources connectées. Seuls ces passages et la question parviennent normalement au modèle de réponse. Un passage utile mentionne donc son sujet, sa règle, ses conditions, son exception et sa date d'effet sans dépendre de “the table above” ou d'une abréviation inexpliquée.
La préparation comporte trois étapes de contrôle distinctes. La gouvernance des sources détermine quelle version fait foi. La qualité d'extraction vérifie le texte réellement reçu par l'index. L'évaluation des réponses teste si des questions réalistes extraient les bonnes preuves et si une absence d'information produit une limite claire plutôt qu'une réponse inventée.
01–11
Configuration pas à pas
Supprimer le contenu redondant, obsolète et superflu
Supprimez les contenus contradictoires de l'ensemble actif au lieu d'essayer de les surclasser.
Regroupez les quasi-doublons par sujet. Les doublons classiques incluent un article actuel accompagné de sa version imprimable, un ancien PDF à côté du nouveau, des URL de sites web avec paramètres, des copies exportées d'espaces de travail et des traductions qui répètent les mêmes faits. Comparez leurs dates d'effet et leur état de validation, puis ne conservez que la version approuvée dans les sources du chatbot.
Archivez les documents obsolètes en dehors du dossier connecté ou du périmètre d'exploration. Le paramètre Search Priority peut ajuster le classement par la suite, mais il ne résout pas de manière fiable les règles contradictoires. Un document obsolète reste accessible lors de la recherche même si sa pondération est plus faible.
Ne supprimez pas l'archive de l'entreprise
Retirez les copies obsolètes de l'ensemble de sources actives du chatbot. Conservez les documents conformément à vos obligations légales et règles de conservation dans l'archive appropriée.
Réécrire les faits essentiels sous forme de sections autonomes
Gardez le sujet, la règle, les conditions et la date regroupés au même endroit.
Remplacez les titres génériques comme “General” ou “More information” par la question précise traitée dans la section : “Support hours for Northstar customers” ou “Annual-plan cancellation eligibility”. Conservez un seul sujet principal par section et utilisez des paragraphes courts sous une véritable structure de titres.
Rédigez des phrases explicites. “It is available for 30 days” devient “The Northstar onboarding review is available for 30 calendar days after the kickoff date.”. Ajoutez les exceptions et la date d'effet dans la même section. Évitez les renvois du type “see above”, car le passage extrait peut ne pas inclure le texte mentionné.
Normaliser les noms, dates, unités et abréviations
Utilisez les termes que les utilisateurs saisissent réellement et expliquez les notions spécialisées dès leur première apparition.
Écrivez le terme complet lors de sa première utilisation, par exemple “Service-level agreement (SLA)”. Conservez des noms de produits et d'offres cohérents d'une source à l'autre. Si les visiteurs disent “refund” alors que la documentation officielle indique “reimbursement”, incluez naturellement les deux formulations dans la section.
Utilisez des dates sans ambiguïté telles que “1 August 2026” ou un format ISO dans les champs structurés. Associez les devises et unités à chaque valeur chiffrée. Indiquez le fuseau horaire pour les horaires et délais. La mention brute “50” n'est pas exploitable lorsqu'elle peut désigner des euros, un pourcentage, des articles ou des minutes.
Convertir les tableaux complexes et images en texte indexable
Ne laissez pas une couleur, la position d'une cellule ou une capture d'écran être le seul support d'une règle.
Les tableaux simples avec une seule ligne d'en-tête et un modèle d'information par ligne sont plus faciles à extraire. Séparez les cellules fusionnées, répétez le sujet de la ligne si nécessaire et ajoutez un court paragraphe résumant la conclusion recherchée par un visiteur. Pour un tableau comparatif, indiquez le produit, la condition, le tarif et la date d'effet sur chaque ligne concernée.
Ajoutez des équivalents textuels pour les schémas et captures d'écran. Une capture d'écran des horaires d'ouverture ne constitue pas une source de connaissances tant que ces horaires n'existent pas aussi sous forme de texte lisible. Dans la mesure du possible, tenez les images décoratives, signatures et éléments de navigation à l'écart du contenu informatif.
Exécuter l'OCR et vérifier l'ordre de lecture extrait
Un PDF peut sembler parfait à l'œil nu tout en fournissant un texte tronqué ou vide au moteur d'indexation.
Essayez de sélectionner et copier une phrase sur chaque type de page. S'il s'agit d'un document numérisé, appliquez une reconnaissance optique de caractères (OCR) avant le téléversement. Vérifiez manuellement les codes, dates, séparateurs décimaux, noms accentués et en-têtes de page, car ce sont des points de défaillance fréquents en OCR.
Collez le texte copié dans un éditeur de texte brut et lisez-le sans la mise en page. Vérifiez l'enchaînement des colonnes, les lignes de tableau, les césures avec tirets et les en-têtes répétés. Réexportez un PDF propre et accessible si l'extraction mélange les colonnes ou supprime des libellés essentiels. Le fait de contrôle de la démonstration doit rester rigoureusement `NORDSTERN-42`.
L'OCR est un brouillon, pas une preuve
Un traitement OCR réussi signifie simplement qu'un texte a été généré. Comparez le texte obtenu avec le document d'origine validé avant de l'indexer.
Téléverser le document nettoyé avec des métadonnées explicites
Rendez la source facilement identifiable dans les filtres, les conversations et les futures révisions.
Ouvrez l'assistant de test isolé, accédez à Data Sources et sélectionnez Add Data Source → Documents. Téléversez le PDF de démonstration validé Northstar. Définissez le Document Name sur “Northstar Knowledge Base” et la Category sur “Support” pour qu'un réviseur comprenne son utilité sans ouvrir le fichier.
Laissez l'optimisation par IA désactivée pour un document propre au texte sélectionnable, sauf en cas de problème d'extraction précis nécessitant une vérification du résultat transformé. Patientez jusqu'à ce que la ligne affiche Completed. Notez le nombre de caractères ou de segments indexés comme référence, et non comme un indicateur de qualité.
Inspecter le texte indexé, les métadonnées et le Search Priority
Vérifiez ce que le moteur de recherche voit réellement, et pas seulement le PDF d'origine.
Cliquez sur Edit pour la base de connaissances Northstar. Lisez le texte extrait stocké autour du premier titre, d'un tableau ou d'une liste, de la dernière section et de NORDSTERN-42. Confirmez que l'éditeur affiche toujours le Document Name et la Category prévus.
Laissez Search Priority à 0 à moins que des tests de recherche reproductibles ne révèlent un conflit justifié. Une valeur plus élevée favorise une source par rapport aux autres ; elle ne corrige ni un mauvais OCR, ni un manque de contexte, ni une règle obsolète. N'enregistrez que les corrections vérifiées et conservez le fichier source approuvé comme document de référence.
Rechercher le fait de contrôle unique dans l'index
Distinguez les anomalies d'extraction et d'indexation des problèmes de génération de réponse.
Sélectionnez Content Search et recherchez `NORDSTERN-42`. Le résultat correspondant doit mentionner la base de connaissances Northstar et afficher le passage stocké contenant ce fait. Répétez l'opération avec une expression courante telle que “support hours” pour vous assurer que la recherche ne fonctionne pas uniquement sur un code atypique.
Si le fait unique ne renvoie aucun résultat, arrêtez-vous avant de modifier le modèle ou le prompt système. Vérifiez l'état de la source, le texte extrait et l'assistant sélectionné. Si Content Search trouve le passage mais que le chatbot échoue dans sa réponse, analysez la formulation de la question, les sources concurrentes, les instructions de rôle et le comportement du modèle.
Exécuter un test à réponse connue et un test sans réponse sécurisé
Un test de validation efficace vérifie à la fois la pertinence de l'extraction et l'honnêteté des limites du chatbot.
Lancez une nouvelle conversation de test avec le chatbot (Test) et demandez : “What is the support verification code in the Northstar Knowledge Base? Answer in one sentence and name the source.” La réponse attendue contient exactement NORDSTERN-42 et identifie le PDF. Notez la formulation exacte obtenue, la version de la source, le modèle et la date.
Ouvrez une autre conversation vierge et demandez la politique de garantie 2028 de Northstar. La source de démonstration ne contient volontairement aucune réponse. Le test est réussi si l'assistant indique que l'information n'est pas disponible au lieu d'inventer une durée ou une condition. Conservez ces deux questions dans votre batterie de tests après chaque modification de source, de prompt ou de modèle.
Versionner, réindexer et réviser la source selon un calendrier défini
Gérez la base de connaissances comme un produit suivi, et non comme un simple téléversement ponctuel.
Lorsqu'un responsable valide une modification, mettez à jour simultanément la source maintenue, la date d'effet et l'entrée du registre. Réindexez ou remplacez la source WebChatAgent, confirmez le statut Completed, vérifiez le passage modifié dans Content Search et relancez la série de questions de test.
Ne supprimez la source remplacée de l'assistant actif qu'une fois la nouvelle version validée. Surveillez les rubriques Questions, Feedback et Conversations pour repérer les formulations réelles non couvertes par le jeu de test. Ajoutez une question dès qu'elle reflète un besoin utilisateur récurrent, puis révisez les sujets critiques selon leur fréquence documentée.
Exemple et résultat
Découvrez le test pratique et son résultat
Chaque tutoriel présente une saisie précise, le résultat attendu et le récapitulatif transparent des vérifications effectuées localement.
Exemple pratique : Base de connaissances chatbot : préparer les documents
Ce cas d'usage exact a été exécuté sur un compte de démonstration temporaire.
Données de test exactes
Search the indexed document content for the exact control value NORDSTERN-42.
Résultat attendu
Content Search trouve NORDSTERN-42 dans le document de base de connaissances validé Northstar.
Ce qui a été réellement vérifié
Le test réel en Light Mode a téléversé et indexé le PDF structuré Northstar. Content Search a ensuite renvoyé NORDSTERN-42 depuis Northstar Knowledge Base.pdf, exactement comme illustré dans la capture de référence.
Conseils et astuces
Rendre la configuration fiable et pérenne
Testez toujours avec des cas réalistes, documentez votre état de référence et n'appliquez qu'un changement à la fois. C'est la seule façon de mesurer de réels progrès.
Privilégier la maintenance aux astuces d'optimisation
Une source qu'un responsable peut comprendre et mettre à jour facilement est bien plus sûre qu'une transformation ponctuelle que personne ne saura reproduire plus tard.
Associer des questions aux responsables de sources
Attribuez à chaque sujet critique une question à réponse connue, une question sans réponse sécurisée et un responsable qui analyse les anomalies.
Gérer distinctement les langues
Déterminez si une source unique dans la langue principale doit répondre aux questions multilingues ou si chaque région dispose de sa propre source dédiée. Évitez les doublons de traduction involontaires.
Mesurer les changements avec le même modèle
Conservez le même modèle, le même prompt et les mêmes formulations de questions lors de l'évaluation d'une réécriture de source. Sinon, vous ne pourrez pas attribuer le résultat aux modifications de la base de connaissances.
Que faire en cas de problème ?
Dépannage
Vérifiez méthodiquement l'état du service, les autorisations d'accès et les données de test avant de modifier le modèle ou le prompt.
Le PDF téléversé affiche Completed, mais le fait de contrôle est absent de Content Search
Ouvrez le texte stocké et comparez-le avec l'original. Vérifiez l'OCR, l'ordre de lecture et assurez-vous que le fichier a été assigné au bon assistant. Réexportez et remplacez la source au lieu de modifier le modèle.
Content Search trouve le passage, mais le chatbot répond avec une ancienne règle
Recherchez dans l'ensemble des sources actives les formulations en double, les URL d'impression, les traductions et les anciens fichiers. Supprimez la copie obsolète, réindexez, démarrez une nouvelle conversation et reposez la même question.
Les valeurs d'un tableau perdent leurs libellés après l'extraction
Remplacez les mises en page fusionnées ou purement visuelles par une ligne d'en-tête simple, répétez le sujet de la ligne et ajoutez un court résumé textuel. Vérifiez le texte stocké avant de tester les réponses.
La réponse connue ne réussit que par intermittence
Utilisez de nouvelles conversations, des formulations rigoureusement identiques et un modèle inchangé. Inspectez les sources concurrentes et les passages extraits avant d'augmenter le paramètre Search Priority. Enregistrez plusieurs essais au lieu de ne retenir que le meilleur.
L'assistant invente une réponse à la question de contrôle sans réponse
Vérifiez qu'aucune source active ne contient d'affirmation approchante, puis renforcez les règles de preuve et de gestion des informations manquantes dans les instructions de rôle. Retestez ensemble les questions connues et inconnues pour que les consignes de sécurité ne bloquent pas les réponses légitimes.
Prêt pour un test en conditions réelles ?
Publiez le registre des sources et le standard de contenu dans votre processus de déploiement. Exigez un responsable, un statut de validation, une date d'effet, une date de révision, une question à réponse connue et un test sans réponse sécurisé pour chaque source stratégique.
Ressources complémentaires
Planifier un chatbot de base de connaissances interne
Associez la préparation des sources aux cas d'usage de l'équipe, aux responsabilités et au contrôle des réponses.
Téléverser et indexer un site web et un PDF
Suivez le parcours pour débutant, d'un assistant vide à deux réponses étayées.
Comprendre chaque commande de Data Sources
Passez en revue les statuts, catégories, textes stockés, Content Search, la réindexation et la suppression.
Tester la non-régression de la base de connaissances finalisée
Transformez vos questions reproductibles en contrôles Knowledge Test et Audit.
Gérer l'absence de preuves en toute sécurité
Associez la qualité des sources à des limites de réponse explicites et à des tests négatifs.