
RAG-chatbot-kennisbank: bedrijfsdocumenten voorbereiden
Maak van verspreide pagina's en pdf's een compacte, beheerde bronnenset waarvan belangrijke feiten eenvoudig te vinden, verifiëren en bij te werken zijn.
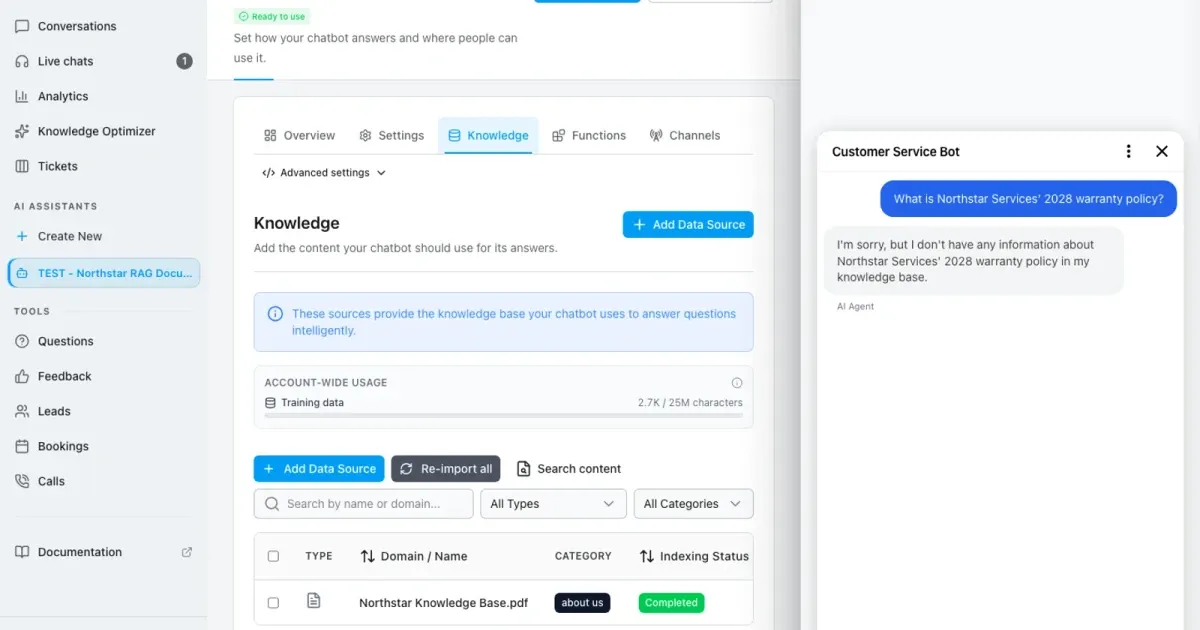
Om een betrouwbare RAG-chatbot-kennisbank voor te bereiden, begint u met goedgekeurde, extraheerbare bedrijfsdocumenten waarvan de opgeslagen fragmenten en antwoordgrenzen direct worden getest.
Een chatbot leest een kennisbank niet zoals een collega die de hele map uit het hoofd kent. Hij ontvangt meestal slechts enkele opgehaalde fragmenten. Als een fragment “this applies for 30 days” vermeldt maar het product, de ingangsdatum en uitzonderingen elders staan, kan het antwoord onvolledig zijn, zelfs als het originele document voor een mens duidelijk leek.
Deze handleiding begint vóór het uploaden. U kiest één goedgekeurde bron per onderwerp, herschrijft belangrijke feiten zodat ze op zichzelf staan, verifieert OCR en extractie, en bewijst vervolgens het geïndexeerde resultaat met één vraag met een bekend antwoord en één opzettelijk onbeantwoorde controlevraag. De Northstar-demo-pdf bevat het unieke feit NORDSTERN-42, zodat het resultaat niet kan worden verward met algemene modelkennis.
Upload niet een hele gedeelde schijf puur omdat deze beschikbaar is. Een kleinere, actuele verzameling met eigenaren, herzieningsdatums en herhaalbare vragen is betrouwbaarder dan een groot archief met tegenstrijdige versies.
Privacyvriendelijke speler met tweestapsactivering
Best practices voor RAG-kennisbanken: verbeter uw chatbotbronnen
Bereid een RAG-kennisbank voor: verwijder dubbele documenten, verbeter extractie, inspecteer geïndexeerde tekst en test ontbrekende antwoorden.
De YouTube-speler blijft geblokkeerd totdat u op Afspelen klikt. Door het laden maakt uw browser verbinding met YouTube en kunnen technische gegevens naar Google worden verzonden.
Rechtstreeks openen op YouTubeWat u aan het einde heeft bereikt
- Een bronnenregister met één verantwoordelijke eigenaar en herzieningsdatum per onderwerp
- Zoekvriendelijke pagina's en documenten met op zichzelf staande feiten
- Op OCR gecontroleerde, ontdubbelde en duidelijk geversioneerde bronbestanden
- Een geïndexeerde WebChatAgent-bron waarvan de opgeslagen tekst zichtbaar is geverifieerd
- Een herhaalbare releasetest voor bekende antwoorden en ontbrekende informatie
Voordat u begint
- Toegang tot de goedgekeurde bronbestanden en openbare pagina's, niet alleen geëxporteerde kopieën
- Een inhoudseigenaar die tegenstrijdigheden kan oplossen en de huidige versie kan goedkeuren
- De downloadbare fictieve Northstar-demo-pdf of een ander niet-gevoelig testdocument
- Vijf tot tien echte gebruikersvragen, inclusief ten minste één vraag die de bronnen niet horen te beantwoorden
- Een geïsoleerde WebChatAgent-testassistent met Engelse interface en Light Mode
Ophalen werkt met tekstfragmenten, dus lokale context is cruciaal
De technische term is Retrieval-Augmented Generation (RAG): het systeem doorzoekt eerst de gekoppelde bronnenset op relevante fragmenten. Alleen die fragmenten en de vraag bereiken normaal gesproken het antwoordmodel. Een bruikbaar fragment vermeldt daarom het onderwerp, de regel, voorwaarden, uitzonderingen en ingangsdatum zonder afhankelijk te zijn van “the table above” of een onverklaarde afkorting.
Voorbereiding kent drie afzonderlijke kwaliteitscontroles. Bronbeheer bepaalt welke versie leidend is. Extractiekwaliteit controleert welke tekst de index daadwerkelijk heeft ontvangen. Antwoordevaluatie test of realistische vragen het juiste bewijs ophalen en of ontbrekend bewijs leidt tot een veilige beperking in plaats van een gok.
01–11
Stap voor stap instellen
Overtollige, verouderde en triviale inhoud verwijderen
Verwijder conflicterende gegevens uit de actieve set in plaats van te proberen ze lager te laten scoren.
Groepeer bijna-dubbels per onderwerp. Typische duplicaten zijn een actueel artikel plus een printversie, een oude pdf naast een nieuwe pdf, website-URL's met parameters, geëxporteerde werkruimtekopieën en vertalingen die dezelfde feiten herhalen. Vergelijk hun ingangsdatums en goedkeuringsstatus, en bewaar alleen de goedgekeurde versie in de bronnenset van de chatbot.
Archiveer vervangen materiaal buiten de gekoppelde map of crawl-scope. Search Priority kan later de rangschikking beïnvloeden, maar is geen veilige oplossing voor tegenstrijdig beleid. Een verouderd document blijft vindbaar, zelfs wanneer het gewicht lager is.
Verwijder niet het bedrijfsarchief
Verwijder verouderde kopieën uit de actieve bronnenset van de chatbot. Bewaar documenten volgens uw wettelijke en bewaarbeleid in het juiste archief.
Belangrijke feiten herschrijven als op zichzelf staande secties
Houd onderwerp, regel, voorwaarden en datum dicht bij elkaar.
Vervang algemene koppen zoals “General” of “More information” door de vraag die de sectie beantwoordt: “Support hours for Northstar customers” of “Annual-plan cancellation eligibility”. Behandel één hoofdonderwerp per sectie en gebruik korte alinea's onder een duidelijke koppenstructuur.
Schrijf expliciete zinnen. “It is available for 30 days” wordt “The Northstar onboarding review is available for 30 calendar days after the kickoff date.” Voeg uitzonderingen en de ingangsdatum toe in dezelfde sectie. Vermijd verwijzingen zoals “see above”, omdat het opgehaalde fragment de waarnaar verwezen tekst mogelijk niet bevat.
Namen, datums, eenheden en afkortingen normaliseren
Gebruik de woorden die bezoekers daadwerkelijk typen en leg vaktermen eenmalig uit.
Schrijf de volledige term bij het eerste gebruik, bijvoorbeeld “Service-level agreement (SLA)”. Houd product- en abonnementnamen consistent over alle bronnen. Als bezoekers “refund” zeggen terwijl het beleid “reimbursement” noemt, neem dan beide termen natuurlijk op in de sectie.
Gebruik eenduidige datums zoals “1 August 2026” of een ISO-datum in gestructureerde velden. Koppel valuta's en eenheden aan elk getal. Vermeld de tijdzone bij openingstijden en deadlines. Een losse “50” is geen bruikbaar feit als het kan gaan om euro's, procenten, artikelen of minuten.
Complexe tabellen en afbeeldingen omzetten naar doorzoekbare tekst
Laat kleur, celpositie of een screenshot niet de enige drager van een regel zijn.
Eenvoudige tabellen met één veldnamenrij en één feitenpatroon per rij zijn eenvoudiger te extraheren. Splits samengevoegde cellen, herhaal het rij-onderwerp waar nodig en voeg een korte alinea toe met de conclusie waar een bezoeker naar kan vragen. Vermeld bij een vergelijkingstabel product, voorwaarde, prijs en ingangsdatum in elke relevante rij.
Voeg tekstuele alternatieven toe voor diagrammen en screenshots. Een screenshot van openingstijden is pas een kennisbron als die tijden ook als leesbare tekst bestaan. Houd decoratieve afbeeldingen, handtekeningen en navigatie-elementen zo veel mogelijk buiten de antwoorddragende inhoud.
OCR uitvoeren en de geëxtraheerde leesvolgorde controleren
Een pdf kan er perfect uitzien terwijl er beschadigde of lege tekst naar de index wordt gestuurd.
Probeer een zin te selecteren en kopiëren van elk paginatype. Als de pagina een scan is, voer dan optische tekenherkenning (OCR) uit vóór het uploaden. Controleer codes, datums, decimaalscheidingstekens, namen met accenten en paginakopteksten handmatig; dit zijn veelvoorkomende OCR-foutpunten.
Plak de gekopieerde tekst in een platte-teksteditor en lees deze zonder de pagina-opmaak. Controleer de volgorde van meerdere kolommen, tabelrijen, afgebroken woorden met koppeltekens en herhaalde kopteksten. Exporteer opnieuw een schone, toegankelijke pdf wanneer de extractie kolommen door elkaar haalt of essentiële labels weglaat. Het democontrolefeit moet exact `NORDSTERN-42` blijven.
OCR is een concept, geen bewijs
Een geslaagde OCR-taak betekent alleen dat er tekst is geproduceerd. Vergelijk de geproduceerde tekst met het goedgekeurde origineel voordat u deze indexeert.
Het schone document uploaden met begrijpelijke metadata
Maak de bron herkenbaar in filters, gesprekken en latere controles.
Open de geïsoleerde assistent, kies Data Sources en selecteer Add Data Source → Documents. Upload de goedgekeurde Northstar-demo-pdf. Stel de documentnaam in op “Northstar Knowledge Base” en de categorie op “Support”, zodat een beoordelaar het doel kan identificeren zonder het bestand te openen.
Laat AI-optimalisatie uitgeschakeld voor een schoon document met selecteerbare tekst, tenzij u een specifiek extractieprobleem hebt en het getransformeerde resultaat zult controleren. Wacht tot de rij Completed toont. Noteer het aantal geïndexeerde tekens of chunks als nulmeting, niet als kwaliteitsscore.
Geïndexeerde tekst, metadata en Search Priority inspecteren
Controleer wat het zoeksysteem daadwerkelijk kan zien, niet alleen de originele pdf.
Open Edit voor Northstar Knowledge Base. Lees de opgeslagen geëxtraheerde tekst rond de eerste kop, één tabel of lijst, de laatste sectie en NORDSTERN-42. Controleer of de editor nog steeds de beoogde Document Name en Category toont.
Laat Search Priority op 0 staan, tenzij herhaalbare zoektests een gerechtvaardigd conflict aantonen. Een hogere waarde geeft een bron voorrang ten opzichte van andere; het herstelt geen slechte OCR, ontbrekende context of een verouderde regel. Sla alleen geverifieerde correcties op en behoud het goedgekeurde bronbestand als het beheerde origineel.
De index doorzoeken op het unieke controlefeit
Scheid extractie- en indexeringsproblemen van problemen met antwoordgeneratie.
Kies Content Search en zoek naar `NORDSTERN-42`. Het overeenkomende resultaat moet Northstar Knowledge Base noemen en het opgeslagen fragment tonen dat het feit bevat. Herhaal dit met een gewone zoekterm zoals “support hours” om er zeker van te zijn dat het ophalen niet beperkt is tot een ongebruikelijke code.
Als het unieke feit geen resultaat oplevert, stop dan voordat u het model of de systeemprompt aanpast. Controleer de bronstatus, geëxtraheerde tekst en de geselecteerde assistent opnieuw. Als Content Search het fragment wel vindt maar het chatbotantwoord mislukt, onderzoek dan de formulering van de vraag, concurrerende bronnen, rolinstructies en het modelgedrag.
Een test met bekend antwoord en een veilige onbekende test uitvoeren
Een nuttige releasetest bewijst zowel correct ophalen als eerlijke beperkingen.
Start een nieuw Test chatbot-gesprek en vraag: “What is the support verification code in the Northstar Knowledge Base? Answer in one sentence and name the source.” Het verwachte antwoord bevat exact NORDSTERN-42 en identificeert de pdf. Noteer de exacte formulering, bronversie, het model en de datum.
Start nog een nieuw gesprek en vraag naar het garantiebeleid van Northstar voor 2028. De bron van de demo heeft hierop opzettelijk geen antwoord. Slagen betekent dat de assistent meldt dat de informatie niet beschikbaar is in plaats van een duur of voorwaarde te verzinnen. Behoud beide vragen in de releaseset na elke wijziging in bron, prompt of model.
Bron versieveren, opnieuw indexeren en periodiek controleren
Behandel de kennisbank als een onderhouden product, niet als een eenmalige upload.
Wanneer een eigenaar een wijziging goedkeurt, werk dan de beheerde bron, de ingangsdatum en het registeritem tegelijkertijd bij. Herindexeer of vervang de WebChatAgent-bron, bevestig Completed, controleer de gewijzigde passage opnieuw in Content Search en voer de vaste vragenset opnieuw uit.
Verwijder de vervangen bron pas uit de actieve assistent nadat de nieuwe versie is geslaagd. Bekijk Questions, Feedback en Conversations voor reële bewoordingen die de testset heeft gemist. Voeg een vraag toe wanneer deze een terugkerende gebruikersbehoefte vertegenwoordigt en controleer kritieke onderwerpen volgens hun gedocumenteerde schema.
Voorbeeld en resultaat
Bekijk de praktijktest en het resultaat
Elke tutorial bevat een vaste invoer, het verwachte resultaat en een transparant overzicht van wat daadwerkelijk lokaal is geverifieerd.
Praktijkvoorbeeld: Chatbot-kennisbank: bedrijfsdocumenten voorbereiden
Dit exacte scenario is doorlopen met het tijdelijke tutorial-account.
Exacte testinvoer
Search the indexed document content for the exact control value NORDSTERN-42.
Verwacht resultaat
Content Search vindt NORDSTERN-42 in het goedgekeurde Northstar-kennisbankdocument.
Wat er daadwerkelijk is geverifieerd
De daadwerkelijke Light Mode-uitvoering heeft de gestructureerde Northstar-pdf geüpload en geïndexeerd. Content Search gaf vervolgens NORDSTERN-42 terug uit Northstar Knowledge Base.pdf, exact zoals te zien is in het bewijskader.
Tips en trucs
Maak de inrichting betrouwbaar
Test met realistische voorbeelden, leg uw startpunt vast en wijzig één instelling tegelijk. Zo worden echte verbeteringen zichtbaar.
Kies voor onderhoud in plaats van optimalisatietrucs
Een bron die een eigenaar betrouwbaar kan begrijpen en bijwerken is veiliger dan een eenmalige transformatie die later niemand meer kan reproduceren.
Koppel vragen aan broneigenaren
Geef elk kritiek onderwerp een vraag met een bekend antwoord, een veilige onbekende vraag en een eigenaar die fouten analyseert.
Scheid talen bewust
Kies of één goedgekeurde brontaal meertalige vragen moet beantwoorden of dat elke taalregio zijn eigen beheerde bron heeft. Voorkom onbedoelde dubbele vertalingen.
Meet wijzigingen met hetzelfde model
Houd het model, de prompt en de formulering van de vraag gelijk tijdens het evalueren van een herschreven bron. Anders kunt u het resultaat niet toeschrijven aan de aanpassing in de kennisbank.
Wanneer iets niet werkt
Problemen oplossen
Controleer status, machtigingen en testgegevens systematisch voordat u het model of de prompt aanpast.
De geüploade pdf toont Completed, maar het controlefeit ontbreekt in Content Search
Open de opgeslagen tekst en vergelijk deze met het origineel. Controleer OCR, de leesvolgorde en of de juiste assistent het bestand heeft ontvangen. Exporteer de bron opnieuw en vervang deze in plaats van het model te wijzigen.
Content Search vindt het fragment, maar de chatbot antwoordt met een oudere regel
Doorzoek de volledige actieve bronnenset op dubbele bewoordingen, print-URL's, vertalingen en oude bestanden. Verwijder het verouderde exemplaar, indexeer opnieuw, start een nieuw gesprek en stel exact dezelfde vraag nogmaals.
Tabelwaarden verliezen hun labels na extractie
Vervang samengevoegde of louter visuele indelingen door een eenvoudige veldnamenrij, herhaal het rij-onderwerp en voeg een korte tekstuele samenvatting toe. Controleer de opgeslagen tekst voordat u antwoorden test.
Het bekende antwoord slaagt slechts af en toe
Gebruik nieuwe gesprekken, identieke bewoordingen en één ongewijzigd model. Inspecteer concurrerende bronnen en opgehaalde fragmenten voordat u Search Priority verhoogt. Leg meerdere runs vast in plaats van alleen de beste te bewaren.
De assistent verzint een antwoord op de onbekende controlevraag
Controleer of geen enkele actieve bron een vergelijkbare bewering bevat en scherp vervolgens de regels voor bewijsvoering en ontbrekende informatie in de rol aan. Hertest de bekende en onbekende vragen samen, zodat de veiligheidsmaatregelen nuttige antwoorden niet onderdrukken.
Klaar voor een test op productieniveau
Publiceer het bronnenregister en de inhoudsstandaard als onderdeel van het releaseproces. Vereis voor elke kritieke bron een eigenaar, goedkeuringsstatus, ingangsdatum, herzieningsdatum, vraag met bekend antwoord en veilige onbekende vraag.
Gerelateerde bronnen
Een interne kennisbank-chatbot plannen
Koppel bronvoorbereiding aan use cases van teams, eigenaarschap en antwoordcontroles.
Een website plus pdf uploaden en indexeren
Volg het stappenplan voor beginners van een lege assistent naar twee onderbouwde antwoorden.
Alle Data Sources-opties begrijpen
Bekijk statussen, categorieën, opgeslagen tekst, Content Search, opnieuw indexeren en verwijderen.
Regressietests uitvoeren op de voltooide kennisbank
Zet herhaalbare vragen om in Knowledge Test- en Audit-controles.
Veilig omgaan met ontbrekend bewijs
Combineer bronkwaliteit met expliciete antwoordgrenzen en negatieve tests.