
Как проиндексировать весь сайт для ИИ-чат-бота
Спланируйте, обойдите и проверьте сайт целиком, не добавляя личные кабинеты, результаты поиска, навигационный мусор и дубли URL.
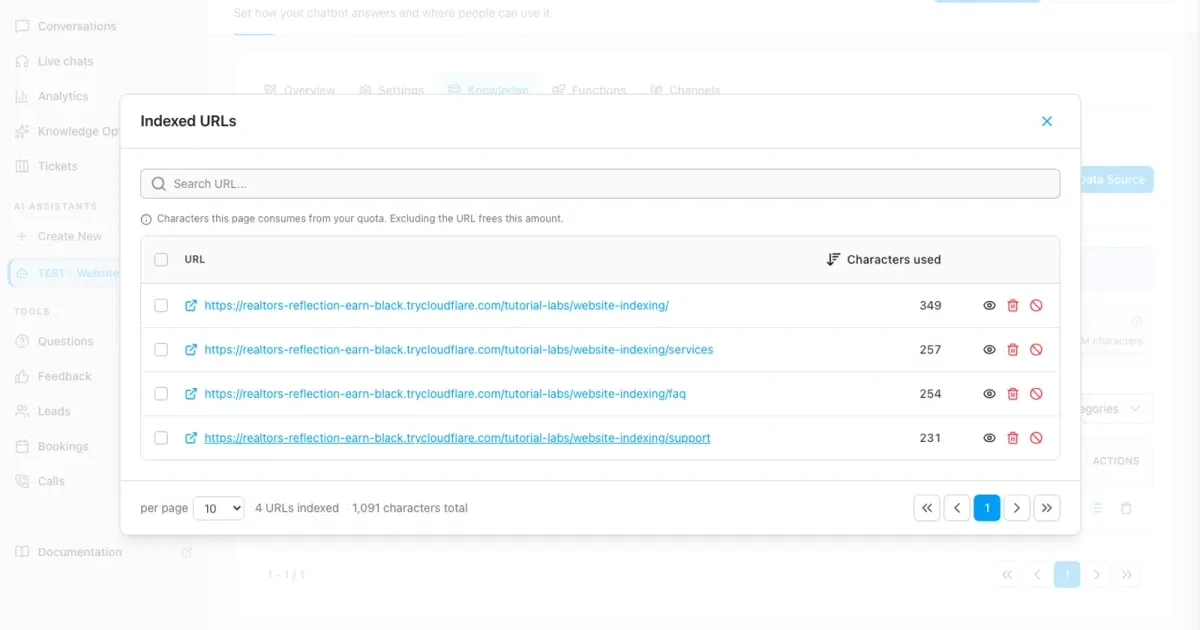
Чтобы надежно проиндексировать весь сайт для чат-бота, сначала составьте точный список полезных страниц, а после краулинга проверьте извлеченный текст и ответы.
Полный сайт — это не просто все URL, которые может найти краулер. Страницы поиска, личные кабинеты, корзина, версии для печати, архивы тегов и дубли на других языках тратят квоту и снижают точность ответов. Безопасная цель — это полный набор только полезных публичных страниц.
В этом руководстве используется тестовый сайт поддержки Northstar с фиксированным списком страниц. Вы начнете с ограниченного обхода, проверите каждый проиндексированный URL и извлеченный текст, уберете постоянный шум шаблонами исключений и протестируете ответы контрольными вопросами перед включением автопереиндексации.
Проверенная демонстрация индексирует ровно четыре канонические страницы, исключает приватные, поисковые и печатные версии, находит `two business hours` и `NORTHSTAR-SITE-42`, корректно отказывается выдумывать комиссию за отмену на 2029 год и сохраняет интервал переиндексации в семь дней. Временный аккаунт удален, пользователей из туториала не осталось.
Видеоплеер с защитой конфиденциальности (запуск в два клика)
Чат-бот проиндексировал не те страницы: настройка краулинга сайта
Индексируйте весь сайт для ИИ-чат-бота с контролем глубины обхода, CSS-селекторами, исключениями, аудитом URL, проверкой ответов и автопереиндексацией.
Плеер YouTube заблокирован до нажатия кнопки воспроизведения. Его загрузка подключает браузер к YouTube и может передавать технические данные в Google.
Открыть напрямую на YouTubeЧто вы узнаете по итогам руководства
- Письменный список включаемых, исключаемых и дублирующих групп URL
- Контролируемый источник сайта с проверенной глубиной обхода, извлечением `main` и правилами исключений
- Постраничный аудит проиндексированных URL, символов и извлеченного текста
- Набор регрессионных тестов с известными ответами и проверкой отсутствующей информации
- Интервал обновления, привязанный к графику владельца контента, а не к случайному расписанию
Перед началом работы
- Разрешение на обход конкретного публичного хоста и пути
- Карта сайта (sitemap) или ручной список ключевых шаблонов страниц
- Известные паттерны личных кабинетов, оформления заказа, поиска, печати, параметров и языковых дублей
- Ответственный за контент и минимум два вопроса с подтвержденными ответами из источника
- Достаточный остаток квоты символов для первого контролируемого обхода
Широкий поиск, выборочная индексация
Глубина обхода (Crawl depth) определяет, на сколько уровней ссылок краулер уходит от начального URL. Значение 0 оставляет обход только на исходной странице; 1 переходит по прямым ссылкам; пустое поле снимает жесткое ограничение глубины. Шаблоны исключений не пускают страницы в индекс, но ссылки с них могут использоваться для поиска.
CSS-селекторы решают другую задачу: какая именно часть каждой допущенной страницы попадет в базу знаний. Селектор вроде `main` удаляет повторяющуюся навигацию и футер, но он обязан присутствовать во всех шаблонах страниц. Статус Completed означает завершение обработки. Список Indexed URLs и тесты с контрольными вопросами подтверждают, что нужные страницы и факты действительно доступны для работы.
01–09
Пошаговая настройка
Составьте карту сайта перед запуском краулера
Отделите полезные страницы от приватных, дублирующих и служебных маршрутов.
Экспортируйте карту сайта или выпишите основные URL вручную. Разделите их на обязательные, опциональные, дубликаты и запрещенные страницы. Зафиксируйте канонический язык и определите, меняют ли параметры сам контент или только сортировку, трекинг и отображение.
В тестовом сценарии Northstar ожидается четыре полезные страницы по пути `/tutorial-labs/website-indexing/`: обзор, услуги, поддержка и FAQ. Приватные, поисковые и печатные варианты исключаются. Этот список служит эталоном: появление лишних страниц считается ошибкой, даже если статус источника горит зеленым.
- Ожидаемые полезные страницы: 4
- Исключенные группы: личные кабинеты, поиск и версии для печати
- Канонический язык: English
Откройте Website у нужного ассистента
Проверьте ассистента, тариф, квоту и подтверждение прав на сайт перед добавлением URL.
Откройте изолированного ассистента `Website Crawl Lab`, перейдите в Data Sources, нажмите Add Data Source и выберите Website. В диалоговом окне четко указано: добавляйте только те сайты, которыми владеете. Не продолжайте, если хост, путь или права не соответствуют утвержденному плану.
Перед началом обхода проверьте карточку Training data usage. Зафиксируйте текущий объем символов, чтобы точно оценить прирост от этого источника. Выбор более мощной модели не компенсирует слишком широкий или несанкционированный обход.
Задайте начальный путь и ограничьте глубину первого обхода
Начните с небольшого объема, чтобы вручную проверить каждую найденную страницу.
Укажите стабильный корневой раздел тестового стенда Northstar и задайте глубину 2 для первого контролируемого запуска. Глубина 0 проиндексирует только страницу обзора. Глубина 1 охватит прямые ссылки. Пустое поле снимает ограничение по уровню вложенности и должно использоваться только на последующих этапах, когда правила исключений уже проверены.
Начинайте с конкретного раздела, а не с главной страницы домена. WebChatAgent ограничивает область поиска указанным путем. Это позволяет создавать отдельные источники сайта, если документации, маркетингу и техподдержке требуются разные селекторы или графики обновления.
Не используйте неограниченную глубину для экономии времени
Сначала подтвердите количество страниц, исключения и корректность извлечения на фиксированной глубине. Увеличивайте уровень по шагам и сравнивайте изменения.
Сохраните основной контент и исключите постоянный шум в URL
Используйте один селектор, присутствующий во всех шаблонах, и явные регистрозависимые паттерны.
Разверните блок Advanced. Указывайте CSS-селектор `main` только после проверки страниц обзора, услуг, поддержки и FAQ. Если селектор отсутствует в каком-то шаблоне, страница получится пустой; если селектор выбран слишком широко, в каждый фрагмент знаний будут попадать меню, баннеры куки и футеры.
Добавьте точные шаблоны исключений для приватных, поисковых и печатных версий. Шаблоны чувствительны к регистру. Проверьте каждый паттерн на реальных URL: слишком общий фрагмент вроде `/shop` может случайно заблокировать страницу `/workshop`. Исключенные страницы не попадают в индекс, но ссылки с них могут использоваться для обнаружения других страниц.
- CSS-селектор: `main`
- Исключить: приватный путь, маршруты поиска и параметры печати
- Не исключайте страницы с юридической информацией, если бот должен отвечать на их основе
Запустите индексацию один раз и правильно читайте статусы
Дождитесь статуса Completed; сразу останавливайте процесс, если область обхода выбрана неверно.
Нажмите Add & Index один раз. Статус Pending означает очередь, Processing — страницы загружаются и обрабатываются, Failed или Error требует анализа ошибки, а Stopped показывает, что обход остановлен вручную. Не создавайте второй источник только потому, что первая задача кажется медленной.
Если количество страниц или символов растет значительно быстрее плана, нажмите Stop, сохраните логи и перепроверьте шаблоны исключений перед повторным запуском с чистого листа. Статус Completed говорит лишь об окончании процесса, но не гарантирует чистоту контента и точность ответов.
Проведите аудит списка проиндексированных URL и расхода квоты
Сверьте точные URL и количество символов на каждой странице со списком плана.
Откройте Indexed URLs в строке сайта. В тестовом стенде должно остаться ровно четыре запланированные канонические страницы. Проверьте список на наличие `private`, `search`, `print`, знаков вопроса и дублей со слешем на конце. Зафиксируйте общий объем символов и сравните прирост с замером до краулинга.
Кнопка Delete удаляет выбранную страницу из текущего индекса, но следующий обход может найти ее снова. Кнопка Exclude дополнительно создает постоянное правило исключения для будущих обходов. Используйте Exclude для нежелательных групп URL, затем запустите переиндексацию и повторно проверьте список страниц и объем символов.
Проверьте извлеченный текст для каждого шаблона
Правильный URL может содержать некорректные области страницы.
Откройте View indexed content для одной страницы каждого типа шаблона. Убедитесь, что заголовок, условия, даты и факты сохранены вместе. Проверьте текст на отсутствие навигационных меню, баннеров cookies, посторонних данных из футера и потерь текста из-за селектора.
Контрольное предложение поддержки Northstar фиксирует срок приоритетного ответа в two business hours и содержит проверочный код `NORTHSTAR-SITE-42`. Если это предложение отсутствует целиком, исправьте правила извлечения контента, прежде чем менять модель или системный промпт.
Проверьте поиск фактов и реакцию на отсутствующую информацию
Задайте контрольные вопросы в новом диалоге после завершения индексации.
Задайте вопрос: `What is the Northstar priority support response goal and website verification value?` Ожидаемый ответ должен содержать `two business hours` и `NORTHSTAR-SITE-42` со ссылкой на страницу поддержки. Затем спросите про комиссию за отмену на 2029 год, которой нет в материалах. Бот должен безопасно ответить, что информация отсутствует, не придумывая суммы.
Повторите контрольный вопрос в двух естественных формулировках. Если бот упускает факт во всех вариантах, вернитесь к проверке извлеченного контента и базы поиска, прежде чем переключать модели. Сохраните эти вопросы как постоянный набор регрессионных тестов для будущих обходов.
Выберите интервал обновления и зафиксируйте базовые показатели
Обновляйте индекс с той же частотой, с которой меняется контент, и сравнивайте одинаковые метрики.
Редактируйте параметры источника сайта только после первого успешного обхода. Выберите вариант без автопереиндексации, раз в день, раз в 3 дня, раз в 7 дней или раз в 30 дней в зависимости от тарифного плана и графика обновления исходных страниц. Ежедневное обновление не дает преимуществ для статичных страниц с регламентами.
После любого изменения селекторов, исключений, провайдера или источника дождитесь статуса Completed и снова задайте контрольные вопросы на известные и отсутствующие факты. Фиксируйте дату, глубину, число страниц, объем символов и результаты тестов. Разбирайте аномальный рост данных до того, как будет исчерпан лимит тарифа.
Пример и результаты тестирования
Практический тест и верификация интерфейса
Каждое руководство содержит фиксированные входные параметры, ожидаемый результат и прозрачный отчет о локально проверенных шагах.
Практический пример: как правильно проиндексировать сайт целиком
Этот тестовый сценарий был полностью выполнен на временном демонстрационном аккаунте.
Тестовые входные данные
Open the indexed Support page and inspect the extracted `main` content for the response goal and verification value.
Ожидаемый результат
Сохраненный текст страницы содержит “two business hours” и `NORTHSTAR-SITE-42`, без элементов навигации и скрытых служебных страниц.
Фактически проверенные результаты
Реальный контролируемый краулинг открыл проиндексированную страницу Support и отобразил оба значения в извлеченном тексте, как зафиксировано на скриншоте.
Полезные советы
Обеспечение надежности настройки
Тестируйте ассистента на реалистичных примерах, фиксируйте базовые результаты и меняйте строго по одной настройке за раз. Это позволит наглядно видеть реальные улучшения.
Разделяйте источники по структуре шаблонов и ответственным
Документация, маркетинг и поддержка часто требуют разных селекторов, правил исключения, владельцев и интервалов обновления. Раздельные корневые пути позволяют быстрее локализовать сбои и контролировать расход квоты.
Осознанно подходите к URL-параметрам
Сохраняйте параметры только тогда, когда они формируют уникальный контент. Параметры трекинга, сортировки, поиска и печати обычно создают дубли; проверяйте конкретные примеры перед составлением широких правил исключения.
Не исключайте страницы регламентов по привычке
Политика конфиденциальности, условия доставки, гарантии или правила возврата часто критически важны для ответов клиентам. Исключайте страницу только в том случае, если она не относится к делу или дублирует контент, а не просто потому, что это юридический документ.
Что делать при возникновении проблем
Устранение неполадок
Систематически проверяйте статус сервиса, права доступа и тестовые данные перед тем, как менять модель или системный промпт.
В индексе появилась только начальная страница
Убедитесь, что глубина обхода больше нуля, полезные ссылки находятся внутри заданного пути, а страницы связаны стандартными URL-ссылками. Проверьте список страниц с ошибками, прежде чем увеличивать глубину.
Страница проиндексирована, но нужный текст отсутствует
Откройте View indexed content и протестируйте CSS-селектор на данном шаблоне. Используйте общий элемент `main` или создайте отдельный источник для проблемного шаблона вместо слепого объединения селекторов.
Исключенные страницы снова появляются после переиндексации
Действие Delete удаляет страницу только из текущего индекса. Добавьте точное правило постоянного исключения (Exclude), перезапустите индексацию и проверьте список URL. Проверьте регистр букв и синтаксис параметров запроса.
Расход символов растет значительно быстрее числа страниц
Проверьте самые объемные страницы на наличие повторяющихся меню, текста cookies, встроенных листингов и вариантов с параметрами. Уточните селектор или разделите сайт на несколько источников, прежде чем докупать квоту.
Источник со статусом Completed дает неверный ответ
Найдите точный фрагмент текста в View indexed content, удалите конфликтующие дубли и повторите контрольный вопрос в новом чате. Переходите к сравнению моделей только после того, как поиск по базе начнет стабильно находить нужный контекст.
Готовы к практическому тестированию
Используйте базовый набор из четырех URL и контрольных вопросов как эталон для релизов. После каждой смены селектора, правила исключения, контента или провайдера дождитесь статуса Completed и сверяйте обновленный список URL, объем символов, извлеченный текст и результаты проверки ответов.