
Come indicizzare un intero sito web per un chatbot AI
Pianifica, scansiona e verifica un sito web completo senza importare aree account, pagine di ricerca, rumore di navigazione o URL duplicati.
Per indicizzare in modo affidabile un intero sito web per un chatbot, definisci prima l'inventario esatto delle pagine utili e verifica sia i contenuti estratti sia le risposte dopo il crawl.
Un sito web completo raramente coincide con tutti gli URL che un crawler può rilevare. Risultati di ricerca, schermate dell'account, percorsi del carrello, visualizzazioni di stampa, archivi di tag e duplicati tradotti possono consumare la quota rendendo le risposte meno affidabili. L'obiettivo sicuro è un set completo di pagine pubbliche utili.
Questa guida utilizza un sito di supporto fittizio di Northstar con un inventario di pagine ridotto e documentato. Inizierai con un crawl limitato, ispezionerai ogni URL indicizzato e il relativo testo estratto, rimuoverai il rumore persistente con pattern di esclusione, quindi verificherai il recupero con domande predefinite prima di abilitare la reindicizzazione automatica.
La procedura verificata scansiona esattamente quattro pagine canoniche, esclude le varianti private, di ricerca e di stampa, recupera `two business hours` più `NORTHSTAR-SITE-42`, rifiuta di inventare una tariffa mancante di 2029 e salva un intervallo di reindicizzazione di sette giorni. L'account temporaneo viene eliminato con zero utenti del tutorial rimanenti.
Player a due clic conforme alla privacy
Il tuo chatbot ha scansionato le pagine SBAGLIATE: correggi l'indicizzazione del sito web
Indicizza un intero sito web per il tuo chatbot AI con crawl controllato, selettori CSS, esclusioni, audit degli URL e reindicizzazione automatica.
Il player di YouTube rimane bloccato finché non selezioni Riproduci. Il caricamento connette il browser a YouTube e potrebbe trasferire dati tecnici a Google.
Apri direttamente su YouTubeCosa otterrai alla fine
- Un inventario scritto delle famiglie di URL inclusi, esclusi e duplicati
- Una sorgente sito web controllata con profondità di crawl testata, estrazione `main` ed esclusioni
- Un audit pagina per pagina degli URL indicizzati, dei caratteri e dei contenuti estratti
- Un set di regressione ripetibile con risposte note e informazioni mancanti
- Un intervallo di aggiornamento allineato con il proprietario dei contenuti anziché con una pianificazione arbitraria
Prima di iniziare
- Autorizzazione per eseguire il crawl dell'hostname pubblico e del percorso esatti
- Una sitemap o un inventario manuale dei template di pagina importanti
- Pattern noti per account, checkout, ricerca, stampa, parametri e lingue duplicate
- Un responsabile dei contenuti più due o più domande con risposte note e supportate da fonti
- Quota di caratteri indicizzati rimanente sufficiente per il primo crawl controllato
Rileva ampiamente, indicizza selettivamente
La profondità di crawl controlla quanti livelli di link vengono rilevati a partire dall'URL iniziale. Zero limita l'esecuzione alla pagina inserita; uno raggiunge le pagine collegate direttamente; un campo vuoto rimuove il limite fisso di profondità. I pattern di esclusione tengono le pagine corrispondenti fuori dall'indice, consentendo comunque ai loro link di favorire la discovery.
I selettori CSS rispondono a una domanda diversa: quale parte di ogni pagina accettata diventa conoscenza. Un selettore come `main` può rimuovere il testo ripetuto di navigazione e footer, ma deve esistere in ogni template di pagina. Lo stato Completed dimostra che l'elaborazione è terminata. Gli URL indicizzati e i test su risposte predefinite confermano che le pagine e i fatti corretti sono effettivamente utilizzabili.
01–09
Configura passo dopo passo
Mappare il sito web prima di aprire il crawler
Separare le pagine utili da percorsi di sola discovery, privati e duplicati.
Esporta la sitemap o elenca manualmente gli URL rappresentativi. Raggruppali come contenuti obbligatori, contenuti opzionali, varianti duplicate e pagine proibite. Registra la lingua canonica e se i parametri modificano il contenuto o solo l'ordinamento, il tracciamento e la presentazione.
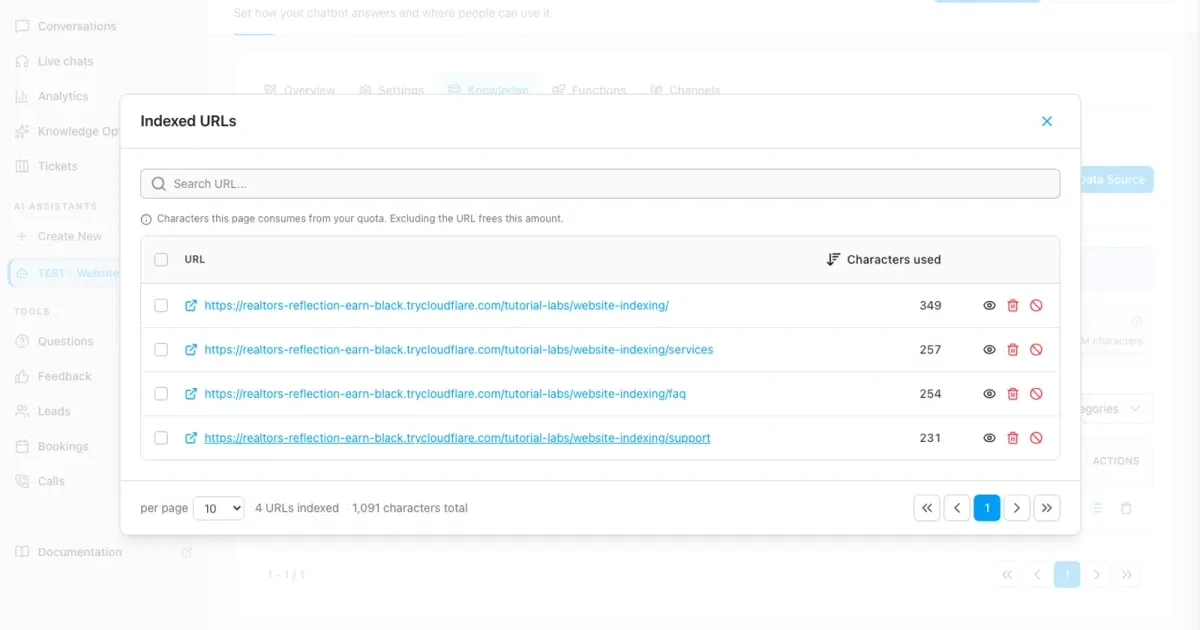
Il lab fittizio di Northstar prevede quattro pagine utili sotto `/tutorial-labs/website-indexing/`: panoramica, servizi, supporto e FAQ. Le varianti private, di ricerca e di stampa sono escluse. L'inventario è il punto di riferimento di test: le pagine impreviste invalidano l'esecuzione anche se lo stato della sorgente è verde.
- Pagine utili previste: 4
- Famiglie escluse: private, ricerca e stampa
- Lingua canonica: inglese
Aprire Website sotto l'assistente corretto
Confermare l'assistente, il piano, la quota e l'avviso di proprietà prima di aggiungere un URL.
Apri l'assistente isolato `Website Crawl Lab`, scegli Data Sources, seleziona Add Data Source e quindi Website. La finestra di dialogo indica esplicitamente di aggiungere solo siti web di tua proprietà. Fermati se l'hostname, il percorso o l'autorizzazione non corrispondono all'ambito approvato.
Controlla la scheda Training data usage prima del crawl. Registra il totale attuale dei caratteri in modo che l'aumento possa essere attribuito a questa sorgente. Un modello più potente non compensa un crawl troppo ampio o non autorizzato.
Impostare il percorso iniziale e una prima profondità limitata
Iniziare con dimensioni ridotte in modo che ogni pagina rilevata possa essere esaminata.
Inserisci la radice stabile del lab Northstar e usa la profondità 2 per la prima esecuzione controllata. La profondità 0 indicizzerebbe solo la panoramica. La profondità 1 raggiunge i link diretti. Una profondità vuota rimuove il limite di livello fisso e va utilizzata solo in un'esecuzione successiva dopo aver testato le esclusioni.
Rimani all'interno della radice della sezione invece di iniziare dalla homepage del dominio. WebChatAgent circoscrive la discovery al percorso iniziale, rendendo utili sorgenti sito web separate quando documentazione, marketing e supporto richiedono selettori o pianificazioni di aggiornamento differenti.
Non usare illimitato come scorciatoia
Verifica prima il conteggio delle pagine, le esclusioni e l'estrazione a una profondità limitata. Espandi un livello alla volta e confronta la differenza.
Mantenere il contenuto principale ed escludere il rumore URL persistente
Utilizzare un selettore presente in tutti i template e pattern espliciti con distinzione tra maiuscole e minuscole.
Espandi Advanced. Imposta il selettore CSS su `main` solo dopo aver verificato panoramica, servizi, supporto e FAQ. Un selettore assente su un template può produrre una pagina vuota, mentre un selettore troppo ampio ripete menu, testi dei cookie e link di piè di pagina in ogni frammento.
Aggiungi pattern di esclusione esatti per le varianti private, di ricerca e di stampa del lab. I pattern fanno distinzione tra maiuscole e minuscole (case-sensitive). Esamina ciascuno rispetto a URL reali; un frammento generico come `/shop` può escludere involontariamente `/workshop`. Le pagine escluse restano fuori dall'indice, ma i loro link possono comunque essere seguiti per la discovery.
- Selettore CSS: `main`
- Esclusioni: percorso privato, route di ricerca e query di stampa
- Non escludere automaticamente le pagine legali se il bot deve rispondere basandosi su di esse
Avviare una sola volta e interpretare correttamente ogni stato
Attendere Completed; interrompere deliberatamente quando l'ambito è visibilmente errato.
Seleziona Add & Index una sola volta. Pending indica che è in coda, Processing significa che le pagine vengono ancora scaricate ed estratte, Failed o Error richiede la verifica del motivo esatto e Stopped indica che un utente ha interrotto l'esecuzione. Non creare una seconda sorgente solo perché il primo processo sembra lento.
Se il conteggio delle pagine o il totale dei caratteri supera ampiamente l'inventario, usa Stop, salva le prove e ispeziona i pattern prima di riprovare con un nuovo account. Completed conferma che il processo è terminato; non dimostra ancora la presenza di contenuti puliti o risposte corrette.
Eseguire l'audit dell'elenco degli URL indicizzati e della quota
Confrontare gli URL esatti e i caratteri per pagina con l'inventario.
Apri Indexed URLs dalla riga del sito web. Il lab deve contenere esattamente le quattro pagine canoniche previste. Cerca `private`, `search`, `print`, punti interrogativi e varianti duplicate con barra finale. Registra i caratteri totali e confronta la differenza con il valore di riferimento prima del crawl.
Delete rimuove subito una pagina indicizzata selezionata, ma un crawl successivo può rilevarla nuovamente. Exclude aggiunge anche un pattern persistente per i crawl futuri. Usa Exclude per una famiglia di URL che deve rimanere esclusa, quindi reindicizza e verifica di nuovo sia l'elenco sia il totale dei caratteri.
Ispezionare il testo estratto da ogni template
Un URL corretto può comunque contenere sezioni di pagina errate.
Usa View indexed content su una pagina per ciascun template. Conferma che intestazione, condizioni, date e informazioni univoche rimangano uniti. Cerca navigazioni ripetute, banner dei cookie, contenuti di piè di pagina non correlati e sezioni mancanti a causa del selettore.
La frase di supporto nota di Northstar afferma che l'obiettivo di risposta prioritaria è di due ore lavorative e include il valore di verifica `NORTHSTAR-SITE-42`. Se la frase completa è assente, correggi l'estrazione prima di modificare il modello o il prompt.
Dimostrare il corretto recupero e la gestione sicura delle informazioni mancanti
Eseguire domande predefinite in una nuova conversazione al termine dell'indicizzazione.
Chiedi: `What is the Northstar priority support response goal and website verification value?` La risposta attesa è `two business hours` più `NORTHSTAR-SITE-42`, basata sulla pagina di supporto. Quindi richiedi una tariffa di cancellazione 2029 che il fixture non contiene. La risposta sicura deve indicare che l'informazione non è disponibile senza inventare alcun importo.
Ripeti la domanda nota con due varianti naturali. Se tutte le varianti non rilevano la stessa informazione, torna ai contenuti estratti e al recupero prima di confrontare i modelli. Conserva queste domande esatte come set di regressione per i crawl successivi.
Scegliere un intervallo di aggiornamento e documentare la baseline
Aggiornare con la frequenza con cui il responsabile dei contenuti modifica la sorgente, quindi confrontare elementi omogenei.
Modifica la sorgente sito web solo dopo il primo risultato pulito. Scegli nessuna reindicizzazione automatica, giornaliera, ogni tre giorni, ogni sette giorni o ogni trenta giorni in base alla disponibilità del piano attuale e al ritmo di revisione del proprietario. L'aggiornamento giornaliero non è automaticamente migliore per pagine statiche di policy.
Dopo ogni modifica a selettori, esclusioni, provider o sorgenti, attendi Completed e riesegui le stesse domande note e su informazioni mancanti. Registra data, profondità, conteggio pagine, caratteri indicizzati ed esiti. Analizza gli aumenti imprevisti prima che raggiungano il limite del piano.
Esempio e risultato
Guarda il test pratico e il relativo risultato
Ogni tutorial include un input definito, il risultato atteso e un riepilogo trasparente di quanto effettivamente verificato in ambiente di prova.
Esempio pratico: come indicizzare correttamente un intero sito web
Questo scenario esatto è stato completato utilizzando l'account di prova temporaneo.
Input esatto del test
Open the indexed Support page and inspect the extracted `main` content for the response goal and verification value.
Risultato previsto
Il testo della pagina memorizzato contiene “two business hours” e `NORTHSTAR-SITE-42`, senza navigazione o contenuti di pagine private.
Cosa è stato effettivamente verificato
Il crawl controllato reale ha aperto la pagina Support indicizzata e ha mostrato entrambi i valori nel contenuto estratto, esattamente come visualizzato nel riquadro delle prove.
Consigli e suggerimenti
Rendi affidabile la configurazione
Esegui i test con esempi realistici, registra i dati di base e modifica una sola impostazione alla volta. In questo modo i miglioramenti reali risulteranno evidenti.
Dividere le sorgenti per titolarità e template
Documentazione, marketing e supporto spesso richiedono selettori, esclusioni, responsabili e intervalli di aggiornamento differenti. Radici separate rendono più semplice isolare errori e aumenti di quota.
Trattare i parametri di query come una decisione ponderata
Mantieni un parametro solo quando produce conoscenza univoca. Varianti di tracciamento, ordinamento, ricerca e stampa generano solitamente duplicati; testa esempi esatti prima di scrivere un pattern generico.
Non rimuovere le policy per abitudine
Le pagine su privacy, spedizioni, garanzia o cancellazione possono essere essenziali per le risposte ai clienti. Escludi una pagina perché irrilevante o duplicata, non solo perché contiene testo legale.
Cosa fare se qualcosa non funziona
Risoluzione dei problemi
Verifica lo stato, i permessi e i dati di test in modo sistematico prima di modificare il modello o il prompt.
Compare solo la pagina iniziale
Verifica che la profondità sia maggiore di zero, che i link utili rimangano all'interno del percorso iniziale e che le pagine siano collegate con URL normali. Ispeziona gli URL non riusciti prima di aumentare la profondità.
Una pagina è indicizzata ma il testo utile risulta mancante
Apri View indexed content e testa il selettore CSS su quel template esatto. Usa un `main` condiviso o una sorgente specifica per il template anziché combinare selettori alla cieca.
Le pagine escluse ricompaiono dopo la reindicizzazione
Delete influisce solo sull'indice corrente. Aggiungi un'esclusione persistente precisa, reindicizza e verifica l'elenco degli URL. Controlla maiuscole/minuscole e sintassi dei pattern di query.
L'utilizzo dei caratteri cresce molto più velocemente del conteggio delle pagine
Ispeziona le pagine più grandi per individuare navigazioni ripetute, testi di cookie, elenchi incorporati e varianti di parametri. Restringi il selettore o dividi la sorgente prima di aumentare la quota.
La sorgente con stato Completed continua a dare una risposta errata
Verifica il passaggio esatto in View indexed content, rimuovi i duplicati in conflitto e riesegui la domanda predefinita in una nuova chat. Confronta i modelli solo dopo che il recupero risulta costantemente corretto.
Pronto per un test strutturato
Mantieni l'inventario di quattro URL e le domande fisse su informazioni note/sconosciute come baseline di rilascio. Dopo ogni modifica a selettori, esclusioni, contenuti o provider, attendi Completed e confronta il nuovo elenco di URL, il totale dei caratteri, la frase estratta ed entrambi i risultati delle risposte.