
Base de conocimiento para chatbot RAG: preparar documentos de empresa
Convierta páginas y PDF dispersos en un conjunto de fuentes reducido y con responsables claros, cuyos datos clave sean fáciles de recuperar, verificar y actualizar.
Para preparar una base de conocimiento fiable para un chatbot RAG, comience con documentos de empresa aprobados y legibles cuyo texto indexado y límites de respuesta se comprueben directamente.
Un chatbot no lee una base de conocimiento como un compañero que recuerda toda la carpeta: suele recibir solo unos pocos fragmentos recuperados. Si un fragmento dice “this applies for 30 days” pero el producto, la fecha de inicio y las excepciones aparecen en otra parte, la respuesta puede ser incompleta aunque el documento original pareciera claro para una persona.
Esta guía comienza antes de subir los archivos. Elegirá una única fuente aprobada para cada tema, reescribirá los datos clave para que sean autosuficientes, verificará el OCR y la extracción, y luego comprobará el resultado indexado con una pregunta de respuesta conocida y una pregunta de control deliberadamente sin respuesta. El PDF de prueba de Northstar incluye el dato exclusivo NORDSTERN-42, por lo que el resultado no podrá confundirse con el conocimiento general del modelo.
No suba una unidad compartida entera solo porque esté disponible. Es mucho más fácil confiar en una colección actual y reducida con responsables asignados, fechas de revisión y preguntas repetibles que en un gran archivo con versiones contradictorias.
Reproductor en dos clics que protege la privacidad
Buenas prácticas para la base de conocimiento RAG: optimice las fuentes de su chatbot
Prepare una base de conocimiento para RAG: elimine duplicados, mejore la extracción, revise el texto indexado y valide las respuestas.
El reproductor de YouTube permanece bloqueado hasta que pulsa Reproducir. Al cargarlo, su navegador se conecta a YouTube y puede transmitir datos técnicos a Google.
Abrir directamente en YouTubeQué obtendrá al final
- Un registro de fuentes con un responsable directo y una fecha de revisión por tema
- Páginas y documentos optimizados para recuperación con información autosuficiente
- Archivos de origen verificados por OCR, sin duplicados y con control claro de versiones
- Una fuente indexada de WebChatAgent cuyo texto almacenado se ha comprobado visualmente
- Una prueba de publicación repetible con respuestas conocidas e información ausente
Antes de empezar
- Acceso a los archivos de origen aprobados y a las páginas públicas, no solo a copias exportadas
- Un responsable del contenido que pueda resolver contradicciones y aprobar la versión actual
- El PDF de prueba ficticio y descargable de Northstar u otro documento de prueba no confidencial
- De cinco a diez preguntas reales de usuarios, incluida al menos una que las fuentes no deban responder
- Un asistente de prueba aislado en WebChatAgent con interfaz en inglés y modo claro (Light Mode)
La recuperación funciona por fragmentos: el contexto local es fundamental
El término técnico es generación aumentada por recuperación (RAG, Retrieval-Augmented Generation): el sistema busca primero fragmentos relevantes en el conjunto de fuentes conectado. Por lo general, solo esos fragmentos y la pregunta llegan al modelo de respuesta. Por tanto, un fragmento útil debe indicar su tema, regla, condiciones, excepciones y fecha de entrada en vigor sin depender de “the table above” o de abreviaturas sin explicar.
La preparación consta de tres filtros de calidad independientes. La gobernanza de fuentes define qué versión es la oficial. La calidad de extracción comprueba qué texto ha recibido realmente el índice. La evaluación de respuestas comprueba si las preguntas realistas recuperan la información correcta y si la falta de datos produce una limitación segura en lugar de una invención.
01–11
Configuración paso a paso
Eliminar contenido redundante, obsoleto e irrelevante
Elimine los conflictos del conjunto activo en lugar de intentar priorizarlos en las búsquedas.
Agrupe los duplicados cercanos por tema. Los duplicados típicos son un artículo actual junto con su vista de impresión, un PDF antiguo junto a uno nuevo, URL de sitios web con parámetros, copias exportadas de espacios de trabajo y traducciones que repiten los mismos datos. Compare sus fechas de entrada en vigor y su estado de aprobación; después, conserve solo la versión aprobada en las fuentes del chatbot.
Archive el material reemplazado fuera de la carpeta conectada o del alcance de rastreo. La Search Priority puede influir en el posicionamiento más adelante, pero no es una solución segura para políticas contradictorias. Un documento desfasado sigue pudiendo recuperarse aunque tenga menor peso.
No elimine el archivo histórico de la empresa
Retire las copias obsoletas del conjunto de fuentes activo del chatbot. Conserve los registros según su política legal y de retención en el archivo correspondiente.
Reescribir datos clave como secciones independientes
Mantenga juntos el asunto, la regla, las condiciones y la fecha.
Sustituya los encabezados genéricos como “General” o “More information” por la pregunta concreta que responde la sección: “Support hours for Northstar customers” o “Annual-plan cancellation eligibility”. Mantenga un solo tema principal por sección y utilice párrafos cortos bajo una jerarquía de encabezados real.
Redacte frases explícitas. “It is available for 30 days” pasa a ser “The Northstar onboarding review is available for 30 calendar days after the kickoff date.”. Añada las excepciones y la fecha de entrada en vigor en la misma sección. Evite referencias como “see above”, ya que el fragmento recuperado podría no incluir el texto al que se hace referencia.
Normalizar nombres, fechas, unidades y abreviaturas
Utilice los términos que los usuarios escriben habitualmente y explique los tecnicismos al menos una vez.
Escriba el término completo la primera vez que aparezca, por ejemplo “Service-level agreement (SLA)”. Mantenga la coherencia en los nombres de productos y planes en todas las fuentes. Si los usuarios suelen escribir “refund” mientras que la política oficial usa “reimbursement”, incluya ambos términos de forma natural en la sección.
Utilice fechas inequívocas como “1 August 2026” o un formato ISO en los campos estructurados. Especifique siempre la moneda y las unidades de medida en cada cifra. Indique la zona horaria en los horarios y plazos. Un “50” sin contexto no es un dato aprovechable si puede referirse a euros, porcentajes, unidades o minutos.
Convertir tablas complejas e imágenes en texto recuperable
No permita que el color, la posición de una celda o una captura de pantalla contengan la única copia de una regla.
Las tablas sencillas con una sola fila de encabezado y un patrón de datos por fila son más fáciles de extraer. Divida las celdas combinadas, repita el asunto de la fila donde sea necesario y añada un párrafo breve que resuma la conclusión sobre la que un usuario podría preguntar. En una tabla comparativa, incluya el producto, la condición, el precio y la fecha de entrada en vigor en cada fila correspondiente.
Añada descripciones de texto alternativas para diagramas y capturas de pantalla. Una captura de pantalla de los horarios de apertura no es una fuente de conocimiento válida hasta que esos horarios existan también como texto legible. Siempre que sea posible, mantenga las imágenes decorativas, firmas y elementos de navegación fuera del contenido que contiene respuestas.
Aplicar OCR y comprobar el orden de lectura extraído
Un PDF puede verse perfecto y, sin embargo, transferir al índice texto incompleto o vacío.
Pruebe a seleccionar y copiar una frase de cada tipo de página. Si la página es un documento escaneado, aplique reconocimiento óptico de caracteres (OCR) antes de subirla. Revise manualmente códigos, fechas, separadores decimales, nombres con tilde y encabezados de página, ya que son puntos donde el OCR suele fallar.
Pegue el texto copiado en un editor de texto plano y léalo sin el diseño de página. Compruebe el orden de las columnas múltiples, las filas de tablas, los guiones de separación de línea y los encabezados repetidos. Vuelva a exportar un PDF accesible y limpio si la extracción mezcla columnas o descarta etiquetas esenciales. El dato de control de la demo debe mantenerse exactamente como `NORDSTERN-42`.
El OCR es un borrador, no una confirmación definitiva
Que un proceso de OCR se complete con éxito solo significa que se ha generado texto. Compare el texto obtenido con el original aprobado antes de indexarlo.
Subir el documento limpio con metadatos descriptivos
Haga que la fuente sea fácil de identificar en filtros, conversaciones y revisiones posteriores.
Abra el asistente de prueba aislado, vaya a Data Sources y seleccione Add Data Source → Documents. Suba el PDF de demostración aprobado de Northstar. Asigne al documento el nombre “Northstar Knowledge Base” y la categoría “Support” para que cualquier revisor pueda identificar su finalidad sin abrir el archivo.
Deje la optimización por IA (AI optimization) desactivada para documentos limpios con texto seleccionable, a menos que tenga un problema de extracción específico y vaya a revisar el resultado transformado. Espere hasta que la fila muestre el estado Completed. Registre el recuento de caracteres o fragmentos indexados como referencia inicial, no como una puntuación de calidad.
Inspeccionar el texto indexado, los metadatos y Search Priority
Revise lo que el sistema de recuperación puede leer realmente, no solo el archivo PDF original.
Abra Edit en la base de conocimiento Northstar. Lea el texto extraído y almacenado alrededor del primer encabezado, una tabla o lista, la sección final y NORDSTERN-42. Confirme que el editor sigue mostrando los valores previstos en Document Name y Category.
Mantenga Search Priority en 0 a menos que pruebas de recuperación repetibles demuestren un conflicto justificado. Un valor más alto destaca una fuente sobre otras, pero no corrige un OCR defectuoso, la falta de contexto o una norma desfasada. Guarde solo las correcciones verificadas y conserve el archivo de origen aprobado como el original de mantenimiento.
Buscar el dato de control exclusivo en el índice
Distinga los problemas de extracción e indexación de los problemas de generación de respuestas.
Vaya a Content Search y busque `NORDSTERN-42`. El resultado coincidente debe indicar la base de conocimiento Northstar y mostrar el fragmento almacenado que contiene el dato. Repita la búsqueda con una frase común como “support hours” para comprobar que la recuperación no se limita solo a códigos poco habituales.
Si el dato exclusivo no devuelve ningún resultado, deténgase antes de modificar el modelo o las instrucciones del sistema (system prompt). Vuelva a comprobar el estado de la fuente, el texto extraído y el asistente seleccionado. Si Content Search encuentra el fragmento pero la respuesta del chatbot falla, analice la redacción de la pregunta, las fuentes en conflicto, las instrucciones de rol y el comportamiento del modelo.
Ejecutar una prueba con respuesta conocida y una con información ausente
Una prueba de publicación eficaz valida tanto la precisión en la recuperación como la capacidad de reconocer sus propios límites.
Inicie una nueva conversación de prueba con Test chatbot y pregunte: “What is the support verification code in the Northstar Knowledge Base? Answer in one sentence and name the source.”. La respuesta esperada debe contener exactamente NORDSTERN-42 e identificar el PDF. Registre la redacción exacta obtenida, la versión de la fuente, el modelo y la fecha.
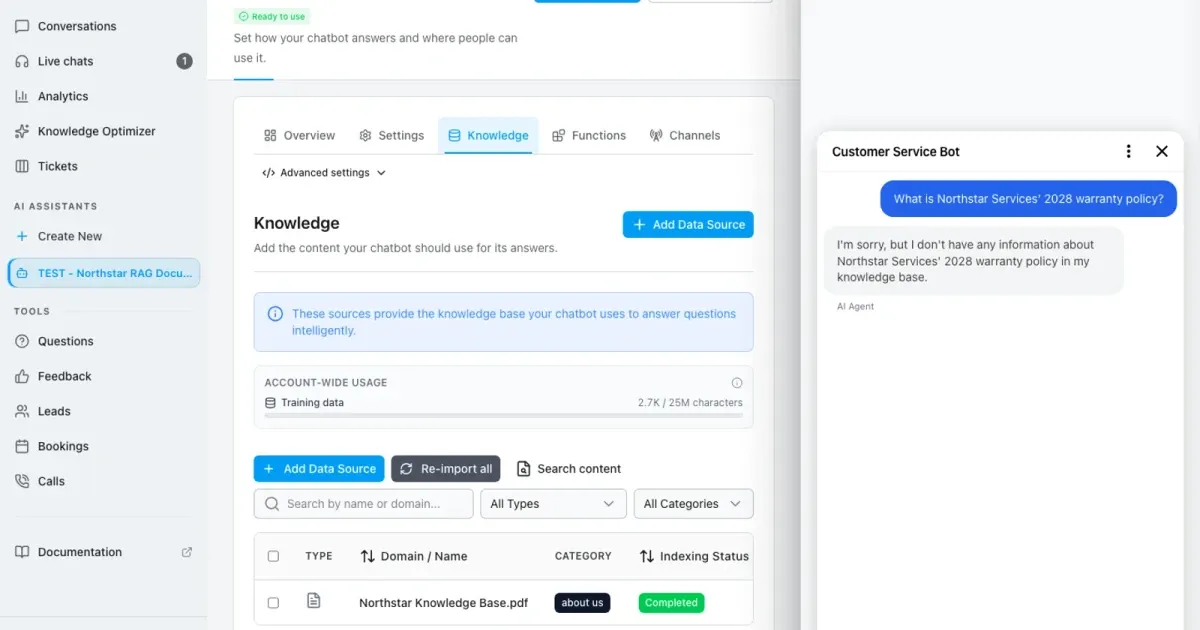
Inicie otra conversación nueva y pregunte por la política de garantía de Northstar para 2028. La fuente de demostración carece intencionadamente de respuesta. La prueba se supera si el asistente indica que la información no está disponible en lugar de inventar un plazo o una condición. Conserve ambas preguntas en el conjunto de pruebas de publicación tras cualquier cambio de fuentes, instrucciones o modelo.
Versionar, reindexar y revisar la fuente de forma periódica
Trate la base de conocimiento como un producto en continuo mantenimiento y no como una carga de archivos puntual.
Cuando un responsable apruebe un cambio, actualice a la vez la fuente de mantenimiento, la fecha de entrada en vigor y la entrada del registro. Reindexe o sustituya la fuente en WebChatAgent, confirme que el estado sea Completed, vuelva a comprobar el fragmento modificado en Content Search y repita el conjunto fijo de preguntas.
Elimine la fuente obsoleta del asistente activo solo cuando la nueva versión haya superado las pruebas. Revise Questions, Feedback y Conversations para identificar términos reales de los usuarios que el conjunto de pruebas no haya previsto. Añada una pregunta cada vez que detecte una necesidad recurrente y revise los temas críticos con la periodicidad establecida.
Ejemplo y resultado
Vea la prueba práctica y su resultado
Cada tutorial incluye un caso de entrada definido, el resultado previsto y un registro transparente de las comprobaciones realizadas.
Ejemplo práctico: Base de conocimiento del chatbot: preparar documentos de empresa
Este escenario exacto se completó con la cuenta temporal del tutorial.
Entrada exacta de la prueba
Search the indexed document content for the exact control value NORDSTERN-42.
Resultado previsto
Content Search localiza NORDSTERN-42 en el documento de base de conocimiento aprobado de Northstar.
Qué se comprobó realmente
La prueba real en modo claro subió e indexó el PDF estructurado de Northstar. A continuación, Content Search devolvió NORDSTERN-42 de Northstar Knowledge Base.pdf, exactamente como se muestra en la captura de verificación.
Consejos útiles
Consiga una configuración fiable
Pruebe con ejemplos realistas, guarde su punto de partida y modifique un solo ajuste cada vez para evaluar las mejoras con claridad.
Priorice el mantenimiento sobre los trucos de optimización
Una fuente que un responsable puede entender y actualizar de forma fiable es más segura que una transformación puntual que nadie pueda reproducir después.
Asignar preguntas a los responsables de las fuentes
Asocie a cada tema crítico una pregunta con respuesta conocida, otra con información no disponible y un responsable que revise los fallos.
Separar los idiomas de forma deliberada
Defina si una única fuente en el idioma principal debe responder a preguntas multilingües o si cada idioma contará con su propia fuente mantenida. Evite traducciones duplicadas involuntarias.
Evaluar los cambios siempre con el mismo modelo
Mantenga fijos el modelo, las instrucciones y la redacción de las preguntas mientras evalúa la reescritura de una fuente. De lo contrario, no podrá atribuir la variación del resultado al cambio en la base de conocimiento.
Si algo no funciona
Resolución de problemas
Revise el estado, los permisos y los datos de prueba de forma sistemática antes de cambiar el modelo o la instrucción.
El PDF subido muestra el estado Completed, pero el dato de control no aparece en Content Search
Abra el texto almacenado y compárelo con el original. Compruebe el OCR, el orden de lectura y si el archivo se ha subido al asistente correcto. Vuelva a exportar y sustituir la fuente en lugar de cambiar el modelo.
Content Search localiza el fragmento, pero el chatbot responde con una regla desfasada
Busque en todo el conjunto de fuentes activo posibles redacciones duplicadas, URL de impresión, traducciones o archivos antiguos. Elimine la copia obsoleta, reindexe, inicie una conversación limpia y repita la misma pregunta.
Los valores de las tablas pierden sus etiquetas tras la extracción
Sustituya los diseños combinados o exclusivamente visuales por una fila de encabezado sencilla, repita el asunto en cada fila y añada un breve resumen en texto. Verifique el texto almacenado antes de evaluar las respuestas.
La respuesta conocida solo se obtiene de forma intermitente
Utilice conversaciones limpias, la misma redacción exacta y un modelo sin cambios. Inspeccione las fuentes en conflicto y los fragmentos recuperados antes de subir la Search Priority. Registre varias ejecuciones en lugar de quedarse solo con el mejor intento.
El asistente inventa una respuesta ante la pregunta de control sin información
Confirme que ninguna fuente activa contenga una afirmación similar y refuerce las reglas de justificación y de información ausente en las instrucciones de rol. Vuelva a probar a la vez las preguntas con respuesta conocida y las no disponibles para que las medidas de seguridad no bloqueen respuestas válidas.
Listo para una prueba tipo producción
Publique el registro de fuentes y los estándares de contenido como parte del proceso de publicación. Exija un responsable, un estado de aprobación, una fecha de entrada en vigor, una fecha de revisión, una pregunta con respuesta conocida y una de control sin respuesta para cada fuente crítica.
Recursos relacionados
Planificar un chatbot de base de conocimiento interna
Vincule la preparación de fuentes con los casos de uso del equipo, la asignación de responsables y la verificación de respuestas.
Subir e indexar un sitio web y un PDF
Siga el flujo básico desde un asistente vacío hasta obtener dos respuestas fundamentadas.
Comprender cada control de Data Sources
Revise estados, categorías, texto almacenado, Content Search, reindexación y eliminación.
Probar la regresión de la base de conocimiento finalizada
Convierta preguntas repetibles en comprobaciones de Knowledge Test y auditoría (Audit).
Gestionar la falta de información con seguridad
Combine la calidad de las fuentes con límites de respuesta explícitos y pruebas de control negativo.