
Cómo indexar un sitio web completo para un chatbot con IA
Planifique, rastree y verifique un sitio web completo sin importar áreas de cuentas, páginas de búsqueda, ruido de navegación ni URL duplicadas.
Para indexar un sitio web completo para un chatbot de forma fiable, defina primero el inventario exacto de páginas útiles y compruebe tanto el contenido extraído como las respuestas tras el rastreo.
Un sitio web completo rara vez equivale a cada URL que un rastreador puede descubrir. Los resultados de búsqueda, pantallas de cuentas, rutas del carrito, vistas de impresión, archivos de etiquetas y duplicados traducidos pueden consumir cuota y hacer que las respuestas sean menos fiables. El objetivo seguro es un conjunto completo de páginas públicas útiles.
Esta guía utiliza un sitio de soporte ficticio de Northstar con un inventario de páginas pequeño y documentado. Comenzará con un rastreo limitado, inspeccionará cada URL indexada y su texto extraído, eliminará el ruido persistente con patrones de exclusión y luego comprobará la recuperación con preguntas fijas antes de habilitar la reindexación automática.
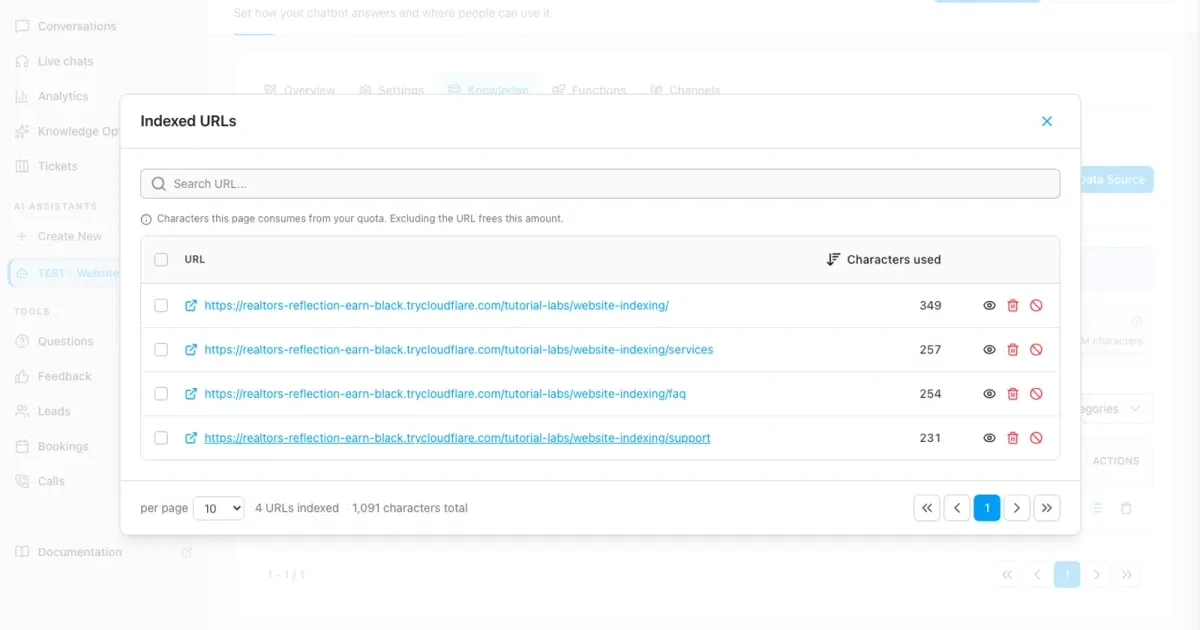
El procedimiento verificado rastrea exactamente cuatro páginas canónicas, mantiene fuera las variantes privadas, de búsqueda y de impresión, recupera `two business hours` más `NORTHSTAR-SITE-42`, se niega a inventar una tarifa inexistente de 2029 y guarda un intervalo de reindexación de siete días. La cuenta temporal se elimina sin que quede ningún usuario del tutorial.
Reproductor en dos clics que protege la privacidad
Su chatbot rastreó las páginas INCORRECTAS: corrija la indexación del sitio web
Indexe su web para un chatbot de IA con rastreo controlado, selectores CSS, exclusiones, auditorías de URL y reindexación automática.
El reproductor de YouTube permanece bloqueado hasta que pulsa Reproducir. Al cargarlo, su navegador se conecta a YouTube y puede transmitir datos técnicos a Google.
Abrir directamente en YouTubeQué obtendrá al final
- Un inventario por escrito de las familias de URL incluidas, excluidas y duplicadas
- Una fuente de sitio web controlada con profundidad de rastreo probada, extracción mediante `main` y exclusiones
- Una auditoría página por página de las URL indexadas, caracteres y contenido extraído
- Un conjunto de regresión reproducible con respuestas conocidas e información faltante
- Un intervalo de actualización adaptado al propietario del contenido en lugar de un cronograma arbitrario
Antes de empezar
- Permiso para rastrear el nombre de host y la ruta públicos exactos
- Un sitemap o un inventario manual de las plantillas de página importantes
- Patrones conocidos de cuentas, pagos, búsquedas, impresiones, parámetros e idiomas duplicados
- Un propietario de contenido más dos o más preguntas con respuestas conocidas respaldadas por las fuentes
- Suficiente cuota restante de caracteres indexados para el primer rastreo controlado
Descubra ampliamente, indexe de forma selectiva
La profundidad de rastreo controla cuántos niveles de enlaces se descubren a partir de la URL de inicio. Cero mantiene la ejecución en la página ingresada; uno llega a las páginas enlazadas directamente; un campo vacío elimina el límite fijo de profundidad. Los patrones de exclusión mantienen las páginas coincidentes fuera del índice, mientras que sus enlaces aún pueden ayudar al descubrimiento.
Los selectores CSS responden a una pregunta diferente: qué parte de cada página aceptada se convierte en conocimiento. Un selector como `main` puede eliminar la navegación repetida y el texto del pie de página, pero debe existir en todas las plantillas de página. El estado Completed demuestra que el procesamiento finalizó. Las URL indexadas y las pruebas de respuesta fijas demuestran que las páginas y los datos correctos son realmente utilizables.
01–09
Configuración paso a paso
Mapear el sitio web antes de abrir el rastreador
Separe las páginas útiles de las rutas de solo descubrimiento, privadas y duplicadas.
Exporte el sitemap o enumere manualmente las URL representativas. Agrúpelas como contenido obligatorio, contenido opcional, variantes duplicadas y páginas prohibidas. Registre el idioma canónico y si los parámetros alteran el contenido o solo la ordenación, el seguimiento y la presentación.
El laboratorio ficticio de Northstar espera cuatro páginas útiles bajo `/tutorial-labs/website-indexing/`: descripción general, servicios, soporte y preguntas frecuentes. Se excluyen las variantes privadas, de búsqueda y de impresión. El inventario es el oráculo de pruebas: las páginas inesperadas invalidan la ejecución incluso si el estado de la fuente aparece en verde.
- Páginas útiles esperadas: 4
- Familias excluidas: privadas, de búsqueda y de impresión
- Idioma canónico: inglés
Abrir Website bajo el asistente correcto
Confirme el asistente, el plan, la cuota y la advertencia de propiedad antes de agregar una URL.
Abra el asistente aislado de `Website Crawl Lab`, elija Data Sources, seleccione Add Data Source y luego Website. El cuadro de diálogo indica explícitamente que solo agregue sitios web de su propiedad. Deténgase si el nombre de host, la ruta o los permisos no coinciden con el alcance aprobado.
Verifique la tarjeta Training data usage antes del rastreo. Registre el total de caracteres actual para poder atribuir el incremento a esta fuente. Un modelo más potente no compensa un rastreo excesivamente amplio o no autorizado.
Establecer la ruta de inicio y una primera profundidad acotada
Comience con un tamaño lo bastante reducido como para que cada página descubierta pueda ser revisada.
Ingrese la raíz estable del laboratorio de Northstar y use la profundidad 2 para la primera ejecución controlada. La profundidad 0 indexaría únicamente la descripción general. La profundidad 1 alcanza los enlaces directos. Una profundidad vacía elimina el límite de nivel fijo y solo corresponde en una ejecución posterior tras haber validado las exclusiones.
Permanezca dentro de la raíz de la sección en lugar de comenzar en la página principal del dominio. WebChatAgent delimita el descubrimiento a la ruta de inicio, lo que hace útiles las fuentes de sitios web independientes cuando la documentación, el marketing y el soporte requieren selectores o calendarios de actualización distintos.
No use ilimitado como un atajo
Primero verifique la cantidad de páginas, las exclusiones y la extracción con una profundidad acotada. Amplíe un nivel a la vez y compare la diferencia.
Conservar el contenido principal y excluir el ruido persistente de URL
Utilice un único selector que exista en todas las plantillas y patrones explícitos que distingan mayúsculas y minúsculas.
Despliegue Advanced. Configure el selector CSS en `main` solo después de revisar la descripción general, los servicios, el soporte y las preguntas frecuentes. Un selector que no esté presente en una plantilla puede generar una página vacía, mientras que uno demasiado amplio repite menús, textos de cookies y enlaces de pie de página en cada fragmento.
Agregue patrones de exclusión exactos para las variantes privadas, de búsqueda y de impresión del laboratorio. Los patrones distinguen entre mayúsculas y minúsculas. Revise cada uno frente a URL reales; un fragmento amplio como `/shop` puede excluir involuntariamente `/workshop`. Las páginas excluidas se mantienen fuera del índice, pero sus enlaces aún pueden seguirse para el descubrimiento.
- Selector CSS: `main`
- Excluir: ruta privada, ruta de búsqueda y consulta de impresión
- No excluya páginas legales automáticamente si el bot debe responder a partir de ellas
Iniciar una vez e interpretar correctamente cada estado
Espere a que figure Completed; detenga deliberadamente el proceso si el alcance es claramente incorrecto.
Seleccione Add & Index una sola vez. Pending significa en cola, Processing significa que las páginas aún se están recuperando y extrayendo, Failed o Error requiere conocer la razón exacta, y Stopped significa que un usuario finalizó la ejecución. No cree una segunda fuente porque el primer trabajo parezca lento.
Si el recuento de páginas o el total de caracteres supera con creces el inventario, use Stop, guarde las pruebas e inspeccione los patrones antes de reintentar con una cuenta limpia. Completed confirma que el trabajo finalizó; aún no demuestra que el contenido esté limpio o que las respuestas sean correctas.
Auditar la lista de URL indexadas y la cuota
Compare las URL exactas y los caracteres por página con el inventario.
Abra Indexed URLs desde la fila del sitio web. El laboratorio debe contener exactamente las cuatro páginas canónicas planificadas. Busque `private`, `search`, `print`, signos de interrogación y variantes duplicadas con barra final. Registre los caracteres totales y compare la diferencia con la línea base previa al rastreo.
Delete elimina ahora una página indexada seleccionada, pero un rastreo posterior puede volver a descubrirla. Exclude también agrega un patrón permanente para futuros rastreos. Use Exclude para una familia de URL que deba permanecer fuera, luego vuelva a indexar y verifique nuevamente tanto la lista como el total de caracteres.
Inspeccionar el texto extraído de cada plantilla
Una URL correcta aún puede contener las regiones de página equivocadas.
Utilice View indexed content en una página de cada plantilla. Confirme que el encabezado, las condiciones, las fechas y el dato único permanezcan juntos. Busque navegación repetida, banners de cookies, contenido de pie de página irrelevante y secciones faltantes debido al selector.
La frase de soporte conocida de Northstar indica que el objetivo de respuesta prioritaria es de dos horas hábiles e incluye el valor de verificación `NORTHSTAR-SITE-42`. Si esa frase completa no aparece, corrija la extracción antes de cambiar el modelo o la instrucción (prompt).
Comprobar la recuperación y el comportamiento seguro ante información faltante
Ejecute preguntas fijas en una conversación nueva una vez finalizada la indexación.
Pregunte: `What is the Northstar priority support response goal and website verification value?` La respuesta esperada es `two business hours` más `NORTHSTAR-SITE-42`, fundamentada en la página de soporte. Luego, pregunte por una tarifa de cancelación de 2029 que la muestra no contiene. La respuesta segura debe indicar que la información no está disponible y no inventar ningún importe.
Repita la pregunta conocida con dos variantes naturales. Si todas las variantes omiten el mismo dato, regrese al contenido extraído y a la recuperación antes de comparar modelos. Conserve estas preguntas exactas como el conjunto de regresión para rastreos posteriores.
Elegir un intervalo de actualización y documentar la línea base
Actualice con la misma frecuencia con la que el propietario del contenido modifica la fuente y luego compare en igualdad de condiciones.
Edite la fuente del sitio web solo después del primer resultado limpio. Elija sin reindexación automática, diaria, cada tres días, cada siete días o cada treinta días según la disponibilidad actual del plan y el ritmo de revisión del propietario. La frecuencia diaria no es automáticamente mejor para páginas de políticas estáticas.
Tras cada cambio de selector, exclusión, proveedor o fuente, espere a que figure Completed y vuelva a ejecutar las mismas preguntas conocidas y de información faltante. Registre fecha, profundidad, recuento de páginas, caracteres indexados y resultados. Investigue cualquier crecimiento inesperado antes de que alcance el límite del plan.
Ejemplo y resultado
Vea la prueba práctica y su resultado
Cada tutorial incluye un caso de entrada definido, el resultado previsto y un registro transparente de las comprobaciones realizadas.
Ejemplo práctico: Cómo indexar un sitio web completo correctamente
Este escenario exacto se completó con la cuenta temporal del tutorial.
Entrada exacta de la prueba
Open the indexed Support page and inspect the extracted `main` content for the response goal and verification value.
Resultado previsto
El texto de la página almacenada contiene “two business hours” y `NORTHSTAR-SITE-42`, sin navegación ni contenido de páginas privadas.
Qué se comprobó realmente
El rastreo controlado real abrió la página Support indexada y mostró ambos valores en su contenido extraído, tal como se muestra en la captura de comprobación.
Consejos útiles
Consiga una configuración fiable
Pruebe con ejemplos realistas, guarde su punto de partida y modifique un solo ajuste cada vez para evaluar las mejoras con claridad.
Dividir las fuentes por propiedad y plantilla
La documentación, el marketing y el soporte a menudo requieren diferentes selectores, exclusiones, propietarios e intervalos de actualización. El uso de raíces independientes facilita aislar fallos y el incremento de cuota.
Tratar los parámetros de consulta como una decisión calculada
Conserve un parámetro solo cuando genere conocimiento único. Las variantes de seguimiento, ordenación, búsqueda e impresión suelen generar duplicados; pruebe ejemplos exactos antes de redactar un patrón amplio.
No eliminar las políticas por costumbre
Las páginas de privacidad, envíos, garantía o cancelación pueden ser esenciales para las respuestas a los clientes. Excluya una página porque sea irrelevante o esté duplicada, no simplemente por ser contenido legal.
Si algo no funciona
Resolución de problemas
Revise el estado, los permisos y los datos de prueba de forma sistemática antes de cambiar el modelo o la instrucción.
Solo aparece la página de inicio
Confirme que la profundidad sea superior a cero, que los enlaces útiles se mantengan bajo la ruta de inicio y que las páginas estén enlazadas con URL normales. Inspeccione las URL fallidas antes de aumentar la profundidad.
Una página está indexada pero falta su texto útil
Abra View indexed content y pruebe el selector CSS en esa plantilla exacta. Utilice un `main` compartido o una fuente específica para la plantilla en lugar de combinar selectores a ciegas.
Las páginas excluidas reaparecen tras la reindexación
Delete afecta solo al índice actual. Agregue una exclusión persistente precisa, vuelva a indexar y verifique la lista de URL. Revise las mayúsculas y la sintaxis del patrón de consulta.
El uso de caracteres crece mucho más rápido que el recuento de páginas
Inspeccione las páginas más grandes en busca de navegación repetida, texto de cookies, listados incrustados y variantes de parámetros. Ajuste el selector o divida la fuente antes de aumentar la cuota.
La fuente en estado Completed sigue dando una respuesta incorrecta
Verifique el fragmento exacto en View indexed content, elimine los duplicados contradictorios y vuelva a ejecutar la pregunta fija en un chat nuevo. Compare modelos solo después de que la recuperación sea sistemáticamente correcta.
Listo para una prueba tipo producción
Conserve el inventario de cuatro URL y las preguntas fijas de datos conocidos/desconocidos como línea base de publicación. Tras cada cambio de selector, exclusión, contenido o proveedor, espere al estado Completed y compare la nueva lista de URL, el total de caracteres, la frase extraída y los resultados de ambas respuestas.